Test-Agent: 您的智能测试助理


本地Mac M1体验效果

魔搭体验效果
魔搭模型访问链接:ModelScope TestGPT-7B

什么是Test Agent?(Introduction)
Test Agent 旨在构建测试领域的“智能体”,融合大模型和质量领域工程化技术,促进质量技术代系升级。我们期望和社区成员一起合作,打造创新的测试领域解决方案,构建24小时在线的测试助理服务,让测试如丝般顺滑。
本期特性(Features)
后续我们会持续迭代模型和工程化能力:
- 不断加入更多令人激动的测试域应用场景,如领域知识问答、测试场景分析等
- 支撑面向测试场景的copilot 工程框架开放,如测试领域知识智能embedding、测试通用工具API体系、智能测试Agent等,敬请期待!
- 以7B为基础,逐步扩展至13B、34B模型。欢迎关注!
性能最强的7B测试领域大模型(Model)
目前在TestAgent中,我们默认使用了TestGPT-7B模型。与当前已有开源模型相比,TestGPT-7B模型在用例执行通过率(pass@1)、用例场景覆盖(平均测试场景数)上都处于业界领先水平。
TestGPT-7B模型核心能力的评测结果如下:
- 多语言测试用例生成
针对模型支持的三种语言:Java、Python、Javascript,Pass@1评测结果如下:
| Model |
Java pass@1 |
Java Average number of test scenarios |
Python pass@1 |
Python Average number of test scenarios |
Javascript pass@1 |
Javascript Average number of test scenarios |
| TestGPT-7B |
48.6% |
4.37 |
35.67% |
3.56 |
36% |
2.76 |
| CodeLlama-13B-Instruct |
40.54% |
1.08 |
30.57% |
1.65 |
31.7% |
3.13 |
| Qwen-14B-Chat |
10.81% |
2.78 |
15.9% |
1.32 |
9.15% |
4.22 |
| Baichuan2-13B-Chat |
13.5% |
2.24 |
12.7% |
2.12 |
6.1% |
3.31 |
- 测试用例Assert补全
目前模型支持Java用例的Assert补全,Pass@1评测结果如下:
| Model |
pass@1 |
Percentage of strong validation |
| Codefuse-TestGPT-7B |
71.1% |
100% |
工程架构(Engineering Architecture)

大模型的号角已经吹响,测试领域大模型也在不断进化中,通过预训练过程中积累的丰富世界知识,在复杂交互环境中展现出了非凡的推理与决策能力。
尽管在测试领域中基础模型取得了显著的成果,但仍然存在一些局限性,特定领域的测试任务通常需要专业化的工具或领域知识来解决。例如,基础模型可以通过预训练知识完成单次测试代码生成和测试文本生成等任务,但处理复杂的集成用例生成、特定领域用例生成和测试流程pipeline交互等问题时,需要更专业的工具和领域知识。因此将专用工具与基础模型整合在一起,可以充分发挥它们各自的优势。专用工具可以解决模型时效性不足、增强专业知识、提高可解释性和鲁棒性的问题。而基础模型则具备类人的推理规划能力,可以理解复杂的数据和场景,并与现实世界进行交互。
在本期开放模型工程化部署和ChatBot基础上,我们将继续在测试开源领域深耕投入。协同社区志趣相投开发者们,一起打造测试领域最领先的Tools工程体系、智能测试助理和测试开源工程!
快速使用(QuickStart)
前置准备
模型下载
您可在modelscope或huggingface上获取到模型的详细信息并下载模型文件。
需要注意的是:
1)如果您通过modelscope下载模型,下载方式可参考:下载说明;
2)如果您通过huggingface下载模型,请确保您可以正常访问huggingface。
环境安装
- python>=3.8
- transformers==4.33.2
git clone https://github.com/codefuse-ai/Test-Agent
cd Test-Agent
pip install -r requirements.txt
在开始运行TestGPT-7B模型之前,请确保你的执行环境拥有大约14GB的显存。
启动服务
项目提供了网页端快速搭建UI的能力能够更直观的展示模型交互和效果,我们可以使用简单的几个命令把前端页面唤醒并实时调用模型能力。在项目目录下,依次启动以下服务:
1.启动controller
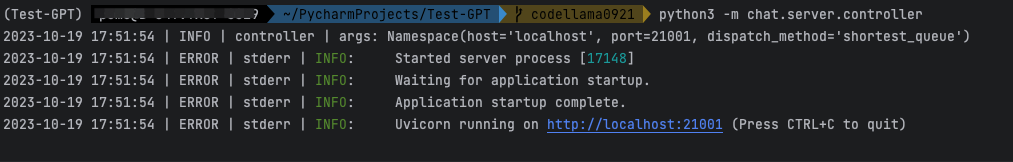 python3 -m chat.server.controller
2.启动模型worker
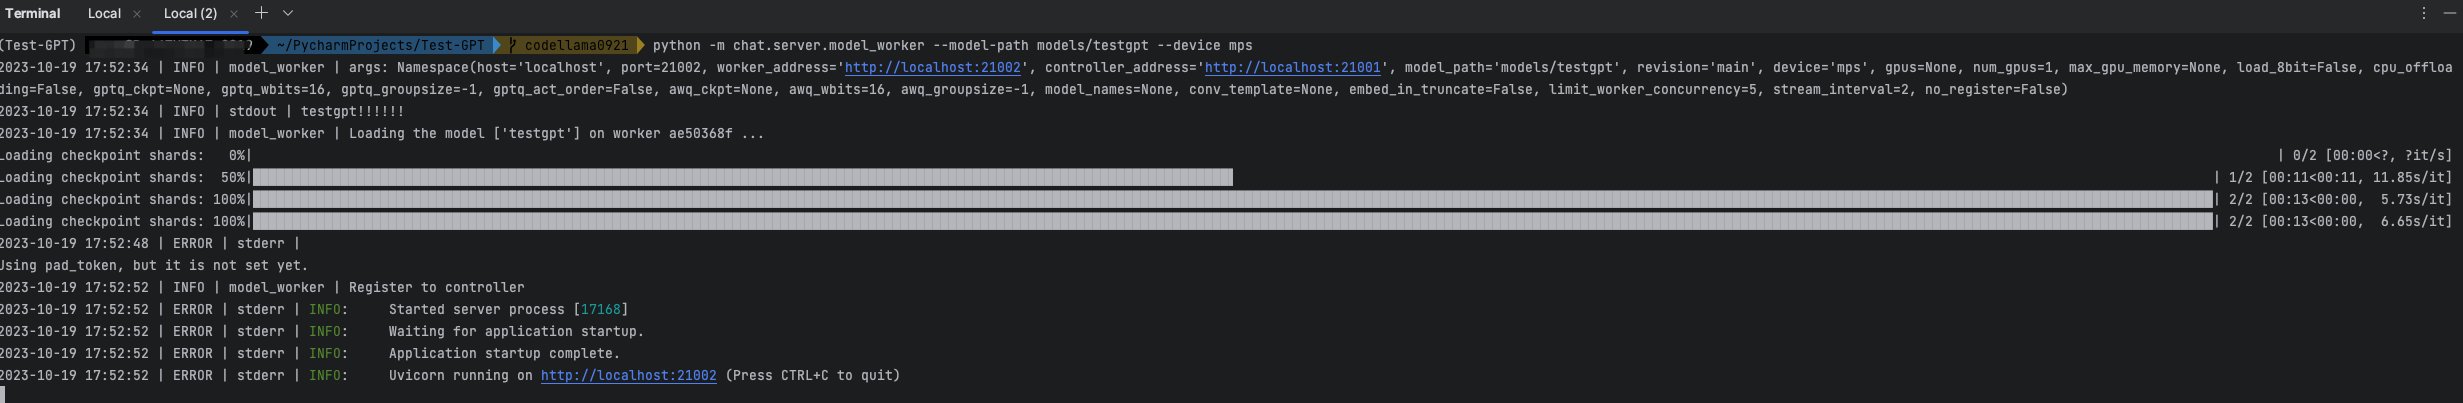 python3 -m chat.server.model_worker --model-path models/TestGPT-7B --device mps
(models/TestGPT-7B 为实际模型文件路径)
对于启动方式,可以按需选择以下几种配置选项:
- –device mps 用于在Mac电脑上开启GPU加速的选项(Apple Silicon或AMD GPUs);
- –device xpu 用于在Intel XPU上开启加速的选项(Intel Data Center and Arc A-Series GPUs);
- –device npu 用于在华为AI处理器上开启加速的选项;
- –device cpu 单独使用CPU运行的选项,不需要GPU;
- –num-gpus 2 指定并发gpu运行的选项。
- 启动web服务
python3 -m chat.server.gradio_testgpt
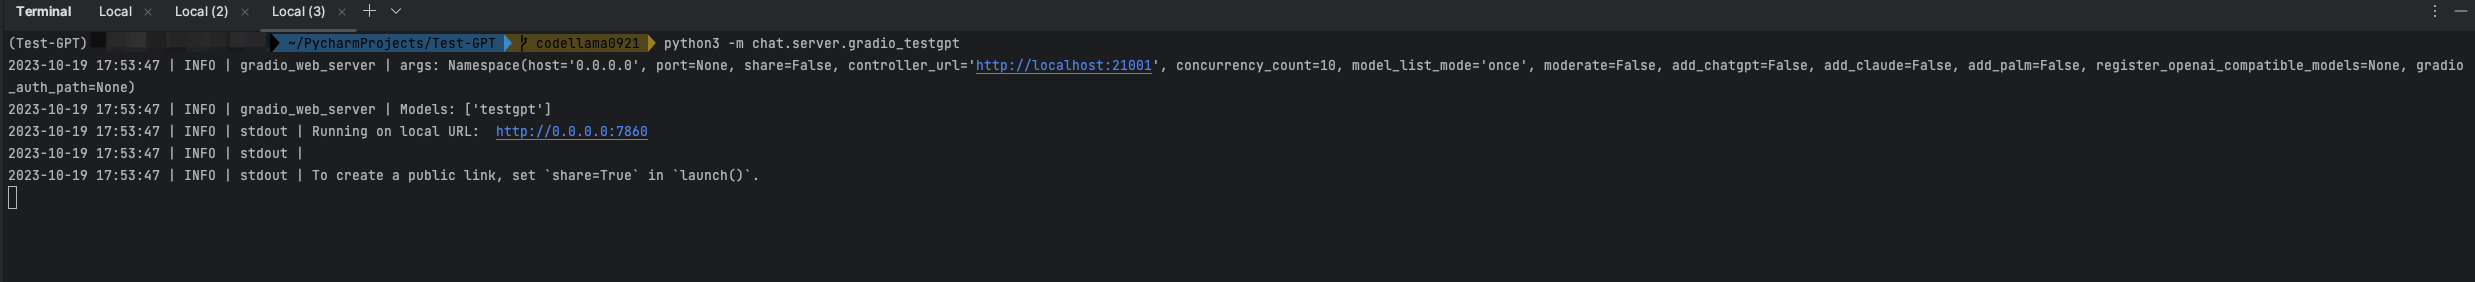 待服务准备就绪后,我们可以打开本地启动的web服务地址 http://0.0.0.0:7860 ,就能看到完整的前端页面了。在页面下方包含了【单测生成】和【Assert补全】的两个例子,点击按钮后会自动生成一段样例文本到输入框中,点击Send按钮就会触发模型运行,之后耐心等待一段时间后(运行时间视本机性能而定)即可看到完整的回答了。

🤗 致谢
本项目基于FastChat 构建,在此深深感谢他们的开源贡献!
联系我们


评论