Apache License 2.0

技术解读

以下内容由 GitRead 中文社区 编辑团队基于项目 README 与官方资料整理, 结合中文开发者的常见使用场景补充技术选型建议。具体以项目官方文档为准。

DoiiarX/NLCISBNPlugin 深度技术分析

项目背景与痛点

在数字图书馆领域,高效便捷地获取图书元数据信息是至关重要的。DoiiarX/NLCISBNPlugin 是一个基于中国国家图书馆(NLC)ISBN检索的Calibre插件,它解决了获取图书元数据信息的痛点。在传统的手动检索中,用户需要分别访问多个图书馆数据库,费时费力。该插件则提供了一站式的解决方案,通过Calibre插件轻松集成到用户现有工作流中,降低了用户使用门槛,提高了效率。

核心技术揭秘

架构与实现原理

DoiiarX/NLCISBNPlugin 的技术架构围绕Calibre的插件机制展开,它利用了网络请求库,通过HTTPS协议发送请求到中国国家图书馆的ISBN检索接口,获取图书元数据信息,最终展示在Calibre插件中。

以下是该插件的架构图:

graph TD A[用户请求] --> B{"参数校验"} B -->|"通过"| C[发送HTTP请求] B -->|"失败"| D[返回错误] C --> E[接收HTTP响应] E --> F[解析响应数据] F --> G[回填图书元数据] G --> H[展示给用户]

关键技术栈与设计模式

该插件主要使用Python编写,依赖于标准库中的网络请求库(如 requests)以及Calibre提供的插件API。此外,插件还包含了必要的异常处理和日志记录,确保在各种调用场景下能够稳定运行。

插件的设计遵循单一职责原则,每一部分都专注于具体的功能,如 NLCISBNPlugin 主要负责发送请求和接收响应,而 metadataParser 则负责解析返回的数据并回填给Calibre。

功能亮点与差异

与其他同类插件相比,DoiiarX/NLCISBNPlugin 的主要亮点在于:

  1. 高度的集成性:直接集成到Calibre中,无需额外操作即可使用。
  2. 直接接入官方数据:基于中国国家图书馆提供的官方API,确保数据准确性和官方授权。
  3. 多语言支持:插件本身提供中文和英语界面,支持更多的国际用户。
  4. 成熟的错误处理机制:内置了丰富的异常处理逻辑,能够优雅地处理网络请求失败等情况。

应用场景与落地建议

应用场景

该插件适用于以下场景:

  • 个体开发者或爱好者:快速添加图书元数据信息至个人电子书库。
  • 图书馆工作者:批量创建、管理和维护电子书库。

落地建议

在生产环境中使用该插件时,需要注意以下几点:

  • 性能监控:通过分布式追踪工具(如 Zipkin)监控性能。
  • 身份认证:配合身份认证和访问权限控制,确保API调用的安全性。
  • 容错与重试机制:处理网络请求的中断和超时,确保服务的稳定性。
  • 资源共享:适当控制并发请求的数量,避免频繁的API调用对服务器的不利影响。

综合评价

优点

  • 高效的数据获取能力,数据源较其他工具更加可靠。
  • 集成度高,可以直接在Calibre环境中使用,用户门槛低。
  • 错误处理机制完善,能够提供较好的用户使用体验。
  • 提供丰富的多语言界面。

缺点

  • 当前仅支持特定的元数据格式,未来的扩展性或灵活性可能受限。
  • 需要稳定的网络环境才能保障插件正常工作。
  • 依赖中国国家图书馆的数据服务,通用性方面需要改进。

总体而言,DoiiarX/NLCISBNPlugin 解决了 Calibre 用户在获取图书元数据时的痛点,通过高效的架构设计和具体的实现原则,为用户提供了高质量的服务。

简要分析

热度分
848
价值分
491
活跃状态
活跃

语言占比

Python

README

🏠中国国家图书馆ISBN Calibre Metadata 源插件

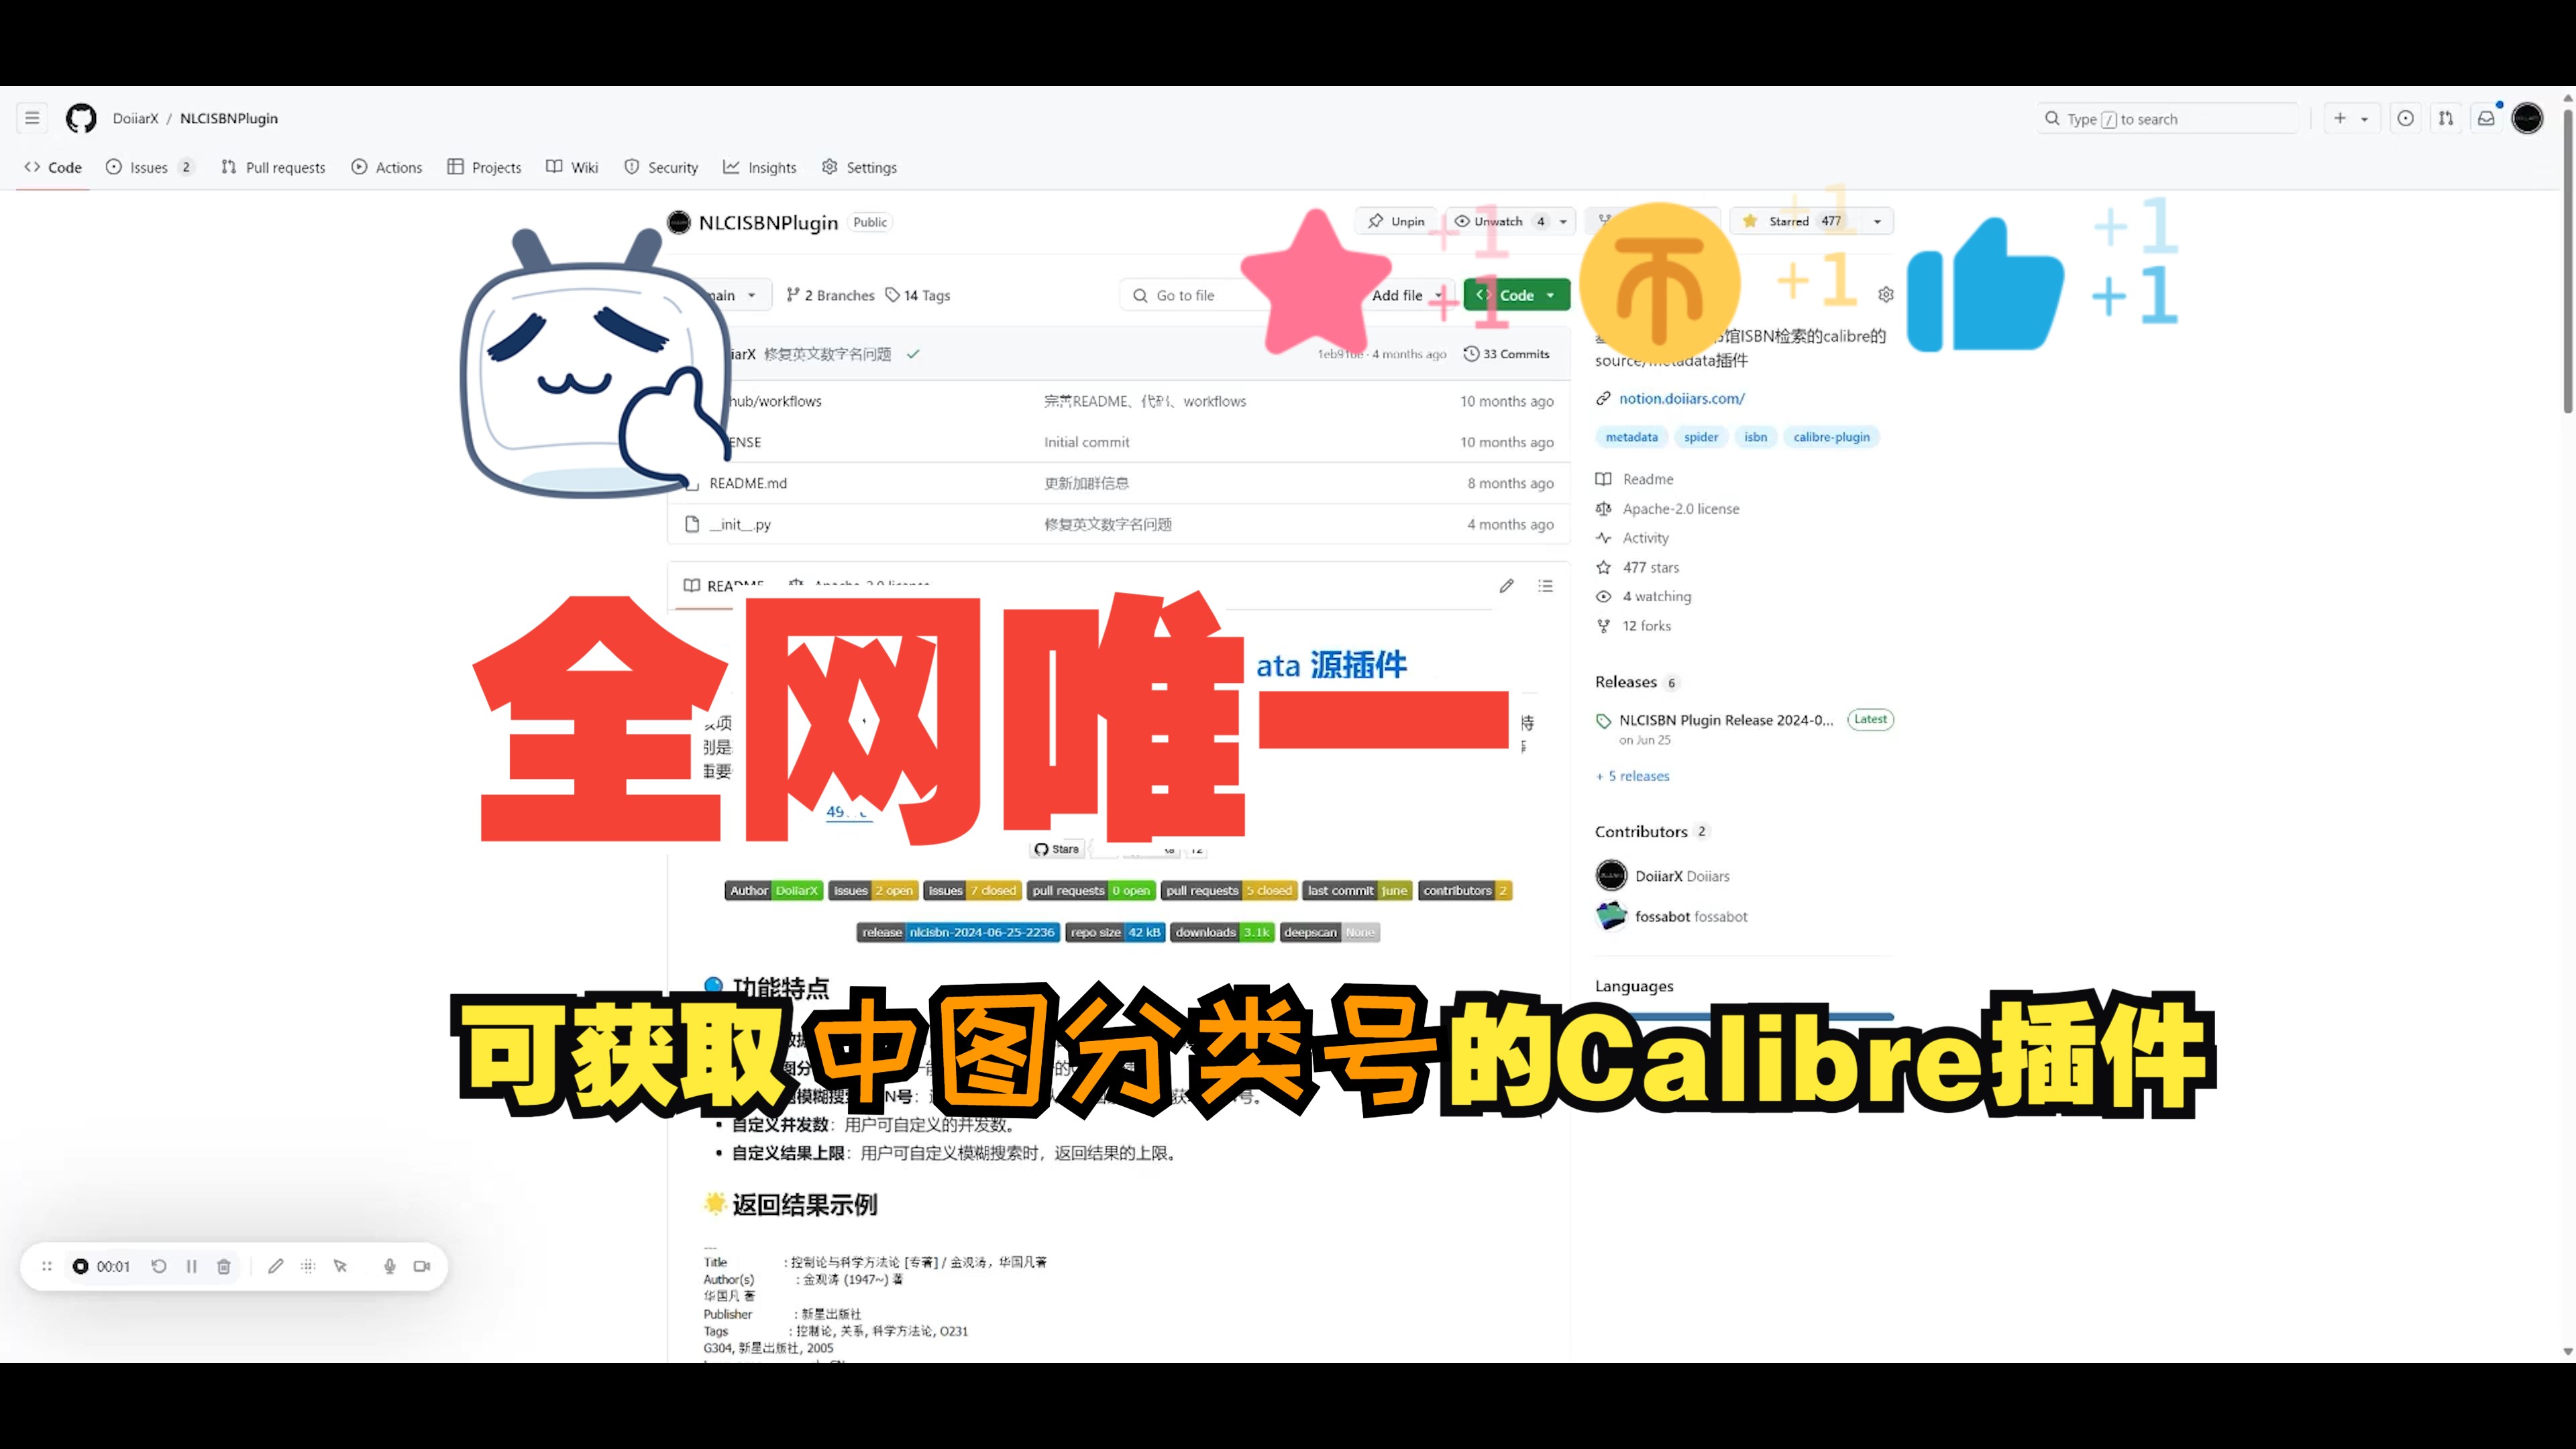
该项目是一个由Doiiars创建的用于 Calibre 电子书管理软件的元数据源插件,旨在从中国国家图书馆获取图书信息,特别是基于ISBN。此插件允许用户轻松地将图书信息添加到其Calibre库中,包括书名、作者、出版日期、中图分类号等重要信息。

(交流反馈QQ群:491708665 (一键加群))

贡献者

文件大小 DeepScan grade

🔍功能特点

  • 自动元数据检索:通过ISBN,自动从中国国家图书馆获取图书元数据。
  • 支持中图分类号:目前唯一能获取中图分类号的Calibre插件。
  • 通过标题模糊搜索ISBN号:通过标题,自动从中国国家图书馆获取ISBN号。
  • 自定义并发数:用户可自定义的并发数。
  • 自定义结果上限:用户可自定义模糊搜索时,返回结果的上限。

🌟返回结果示例

image FOSSA Status

返回项目包括:

  • 书名
  • 标签
  • 作者
  • 简介
  • 出版社

其中,标签由分类、图书馆分类号、出版年份组成

✅待办事项

以下是我们计划在未来添加到插件中的功能:

  • 模糊搜索:根据isbn搜索isbn相同的多本书籍。

❤ 赞助 Donation

如果你觉得本项目对你有帮助,请考虑赞助本项目,以激励我投入更多的时间进行维护与开发。

If you find this project helpful, please consider supporting the project going forward. Your support is greatly appreciated.

Donation

你的star或者赞助是我长期维护此项目的动力所在,由衷感谢每一位支持者,“每一次你花的钱都是在为你想要的世界投票”。 另外,将本项目推荐给更多的人,也是一种支持的方式,用的人越多更新的动力越足。

👤游客访问

NLCISBNPlugin

📺视频教程

🔧安装

  1. 在 Calibre官方网站 上下载并安装Calibre。

  2. 下载最新版本的 NLCISBNPlugin 插件文件。

  3. 打开Calibre软件,点击 “首选项” > “插件”。

  4. 在插件界面中,点击 “加载插件从文件中” 按钮,选择之前下载的插件zip文件。

  5. 安装完成后,启用该插件。

📘使用

  1. 打开Calibre软件。

  2. 选择您想要更新元数据的电子书。

  3. 右键单击所选电子书,然后选择 “编辑元数据”。

  4. 在 “元数据编辑器” 窗口中,点击 “下载元数据”。

  5. 插件将自动从中国国家图书馆检索并填充图书信息。

  6. 确认信息无误后,点击 “确定” 保存更新的元数据。

⚠️可能遇到的麻烦

  1. 无法安装插件。报错 It does not contain a top-level init.py file
  2. 当单一isbn对应多本书籍时,无法下载元数据

🤝贡献

如果您发现任何问题或想要改进这个插件,欢迎贡献您的代码。请按照以下步骤进行:

  1. Fork 该仓库。

  2. 创建一个新的分支,以进行您的改进。

  3. 提交您的更改并创建一个拉取请求(Pull Request)。

  4. 我们将会审查您的代码并与您合作以将改进合并到主分支。

📜许可证

这个项目基于 Apache 许可证 2.0 开源,因此您可以自由使用、修改和分发它。

💬 感谢

感谢您对中国国家图书馆ISBN Calibre Metadata 源插件的兴趣和支持!如果您有任何问题或建议,欢迎在 GitHub 上的问题部分提出。

💥​相关项目推荐(EbookDataGeter、managebooks)

1. EbookDataGeter 是一个基于 NLCISBNPlugin 的改进项目,同时也是 EbookDataTools 系列工具的第二个项目,本项目提供了一个简单易用的图书数据获取工具。 如果你希望摆脱calibre的繁复,只希望获得纯粹的书籍元数据,那么EbookDataGeter就值得你去尝试。

https://github.com/Hellohistory/EbookDataGeter

image

2. managebooks 是一款优雅的 个人实体书 图书管理工具,让你的藏书井然有序。告别重复购书,轻松管理每一本珍藏。

✨核心特色

多样化展示:封面墙、列表、表格等多种视图模式,随心切换

智能录入:支持ISBN录入,自动获取豆瓣图书信息

数据本地化:所有数据存储在本地,安全可靠无忧

丰富的分类管理:支持中图分类、自定义存放位置标记

便捷的统计分析:

购书折扣分析

年度购书统计

藏书分类占比

购书趋势追踪

https://www.douban.com/group/topic/296998935/?_i=0261689D4vGJ3w

4R%O)CMXNC`} M)_EV _K4S

📊Star History

Star History Chart

License

FOSSA Status

评论

暂无评论