dsh-free-search

DeepSeek Harness 免费搜索插件:无需 API key,零成本,多引擎可切换。 这是一个给 DeepSeek Harness (dsh) 添加多引擎搜索 provider 的插件,注册进 ctx.web seam。内置 web_search 工具自动选用,支持网页设置页切换引擎、配置 API key、一键测试所有引擎、弹出式命令切换引擎。
中文 · English
中文
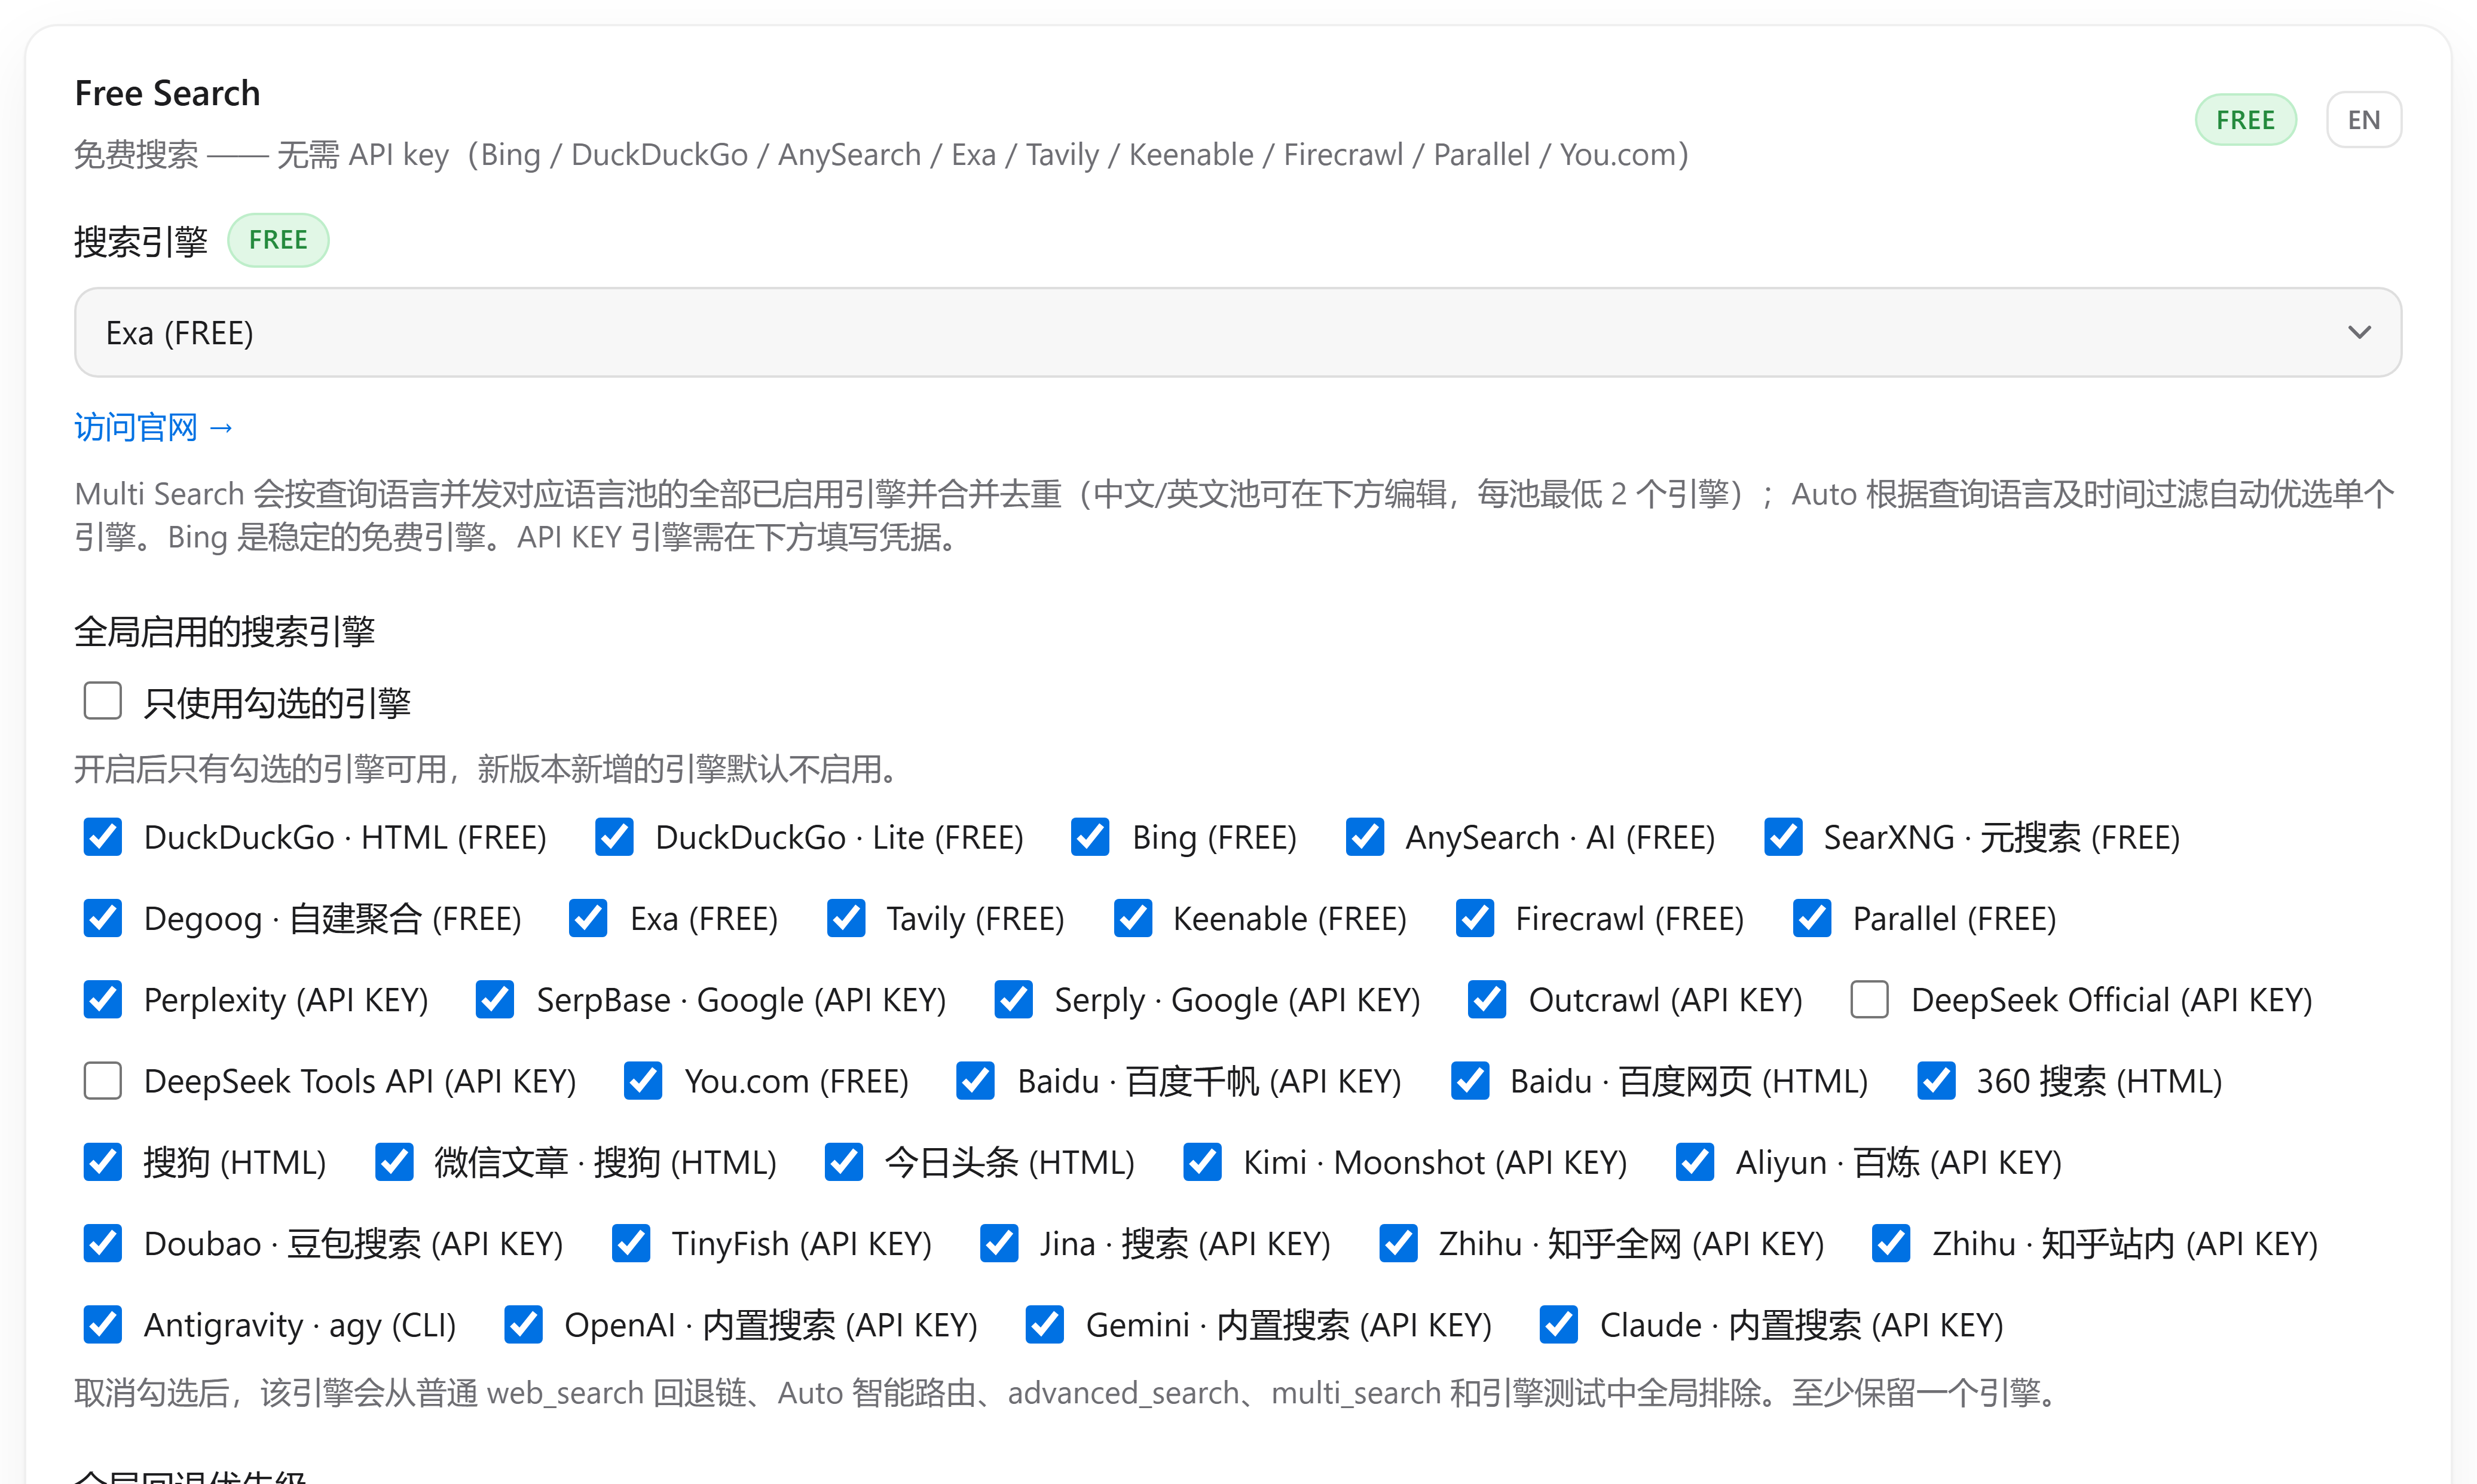
 ▲ 设置页总览
谁需要它
如果你:
- 没有(或不想)配置 DeepSeek 官方 key,用第三方模型供应商发现无法搜索
- 虽然配置了官 key,但用的明明是第三方模型供应商,结果 DeepSeek 账户却依旧扣费
这一切都是因为 dsh 默认的搜索 provider 依赖 DeepSeek 官方 API key(DEEPSEEK_API_KEY)。没有配置官 key,内置搜索就会失败;配置了官 key,即使用第三方模型供应商,搜索时也会使用官方渠道,产生隐形扣费。
这个插件就是来解决这些问题的:它提供多个免费引擎 + 自动回退,让 DSH 彻底摆脱 DeepSeek 官方 key 的依赖。
特性
引擎与切换
- 零成本 —— 多个免费引擎,无需 key、无需注册
- 39 个引擎可选:DuckDuckGo(html/lite)、Bing、SearXNG(元搜索,支持自定义实例)、AnySearch、Exa、Tavily、Keenable、Firecrawl、Parallel、Perplexity、SerpBase、Serply、Outcrawl、Google 自定义搜索(
google,需 API key + CSE ID)、秘塔搜索(metaso,官方 API,按点数计费)、Yandex 搜索(yandex,官方 API,按请求计费,需 folder ID)、腾讯元宝搜索(yuanbao,API key 网关,有活动免费额度)、DeepSeek 官方、DeepSeek 原生搜索 API、You.com、百度千帆、Kimi、阿里云百炼、火山联网搜索(豆包搜索)、知乎全网/站内(zhihu_global/zhihu_site,经知乎开放平台 MCP)、Antigravity CLI 搜索(agy,需本机安装)、OpenAI / Gemini / Claude 模型内置搜索。默认自动回退链覆盖其中 28 个;5 个 HTML SERP 引擎默认不参与,OpenAI / Gemini / Claude 三个模型引擎、Metaso、Yandex 和 Yuanbao 都只在显式点名时运行。
- 5 个 HTML 搜索页引擎(默认关闭) —— 把传统搜索页并入同一套引擎 / 回退 / 冷却 / 设置体系:
baidu-html(百度网页)、so360、sogou、wechat(微信文章)、toutiao。免 key、免额度,代价是抓页面:验证码/反爬按 bot-wall 归类并让整个家族冷却 10 分钟(整段出口 IP 都会被打标),结果也没有 API 摘要。它们默认不进 auto / 回退链 / 语言池,只在显式 engine= 或加入语言池时运行。
- 引擎白名单 —— 设置页「只使用勾选的引擎」开启后,只有勾选的引擎可用,升级新增的引擎默认不启用;配置里对应
allowedEngines(非空时等价于把其余引擎全部禁用)。
- 全局引擎开关与回退优先级 —— 设置页可勾选/取消引擎(取消后全局生效:普通搜索 / Auto /
advanced_search / multi_search / 引擎测试都不再用它),并可用 ↑↓ 调整全局回退顺序(一键恢复默认)。
- 弹出式切换命令 —— 聊天框输入
/free-search-engine,弹出引擎选择窗口,点选即切换(等效设置页 + 保存)。
- 免费标注 —— 设置页中免费引擎带绿色
FREE 徽章,付费引擎带橙色 API KEY 徽章。
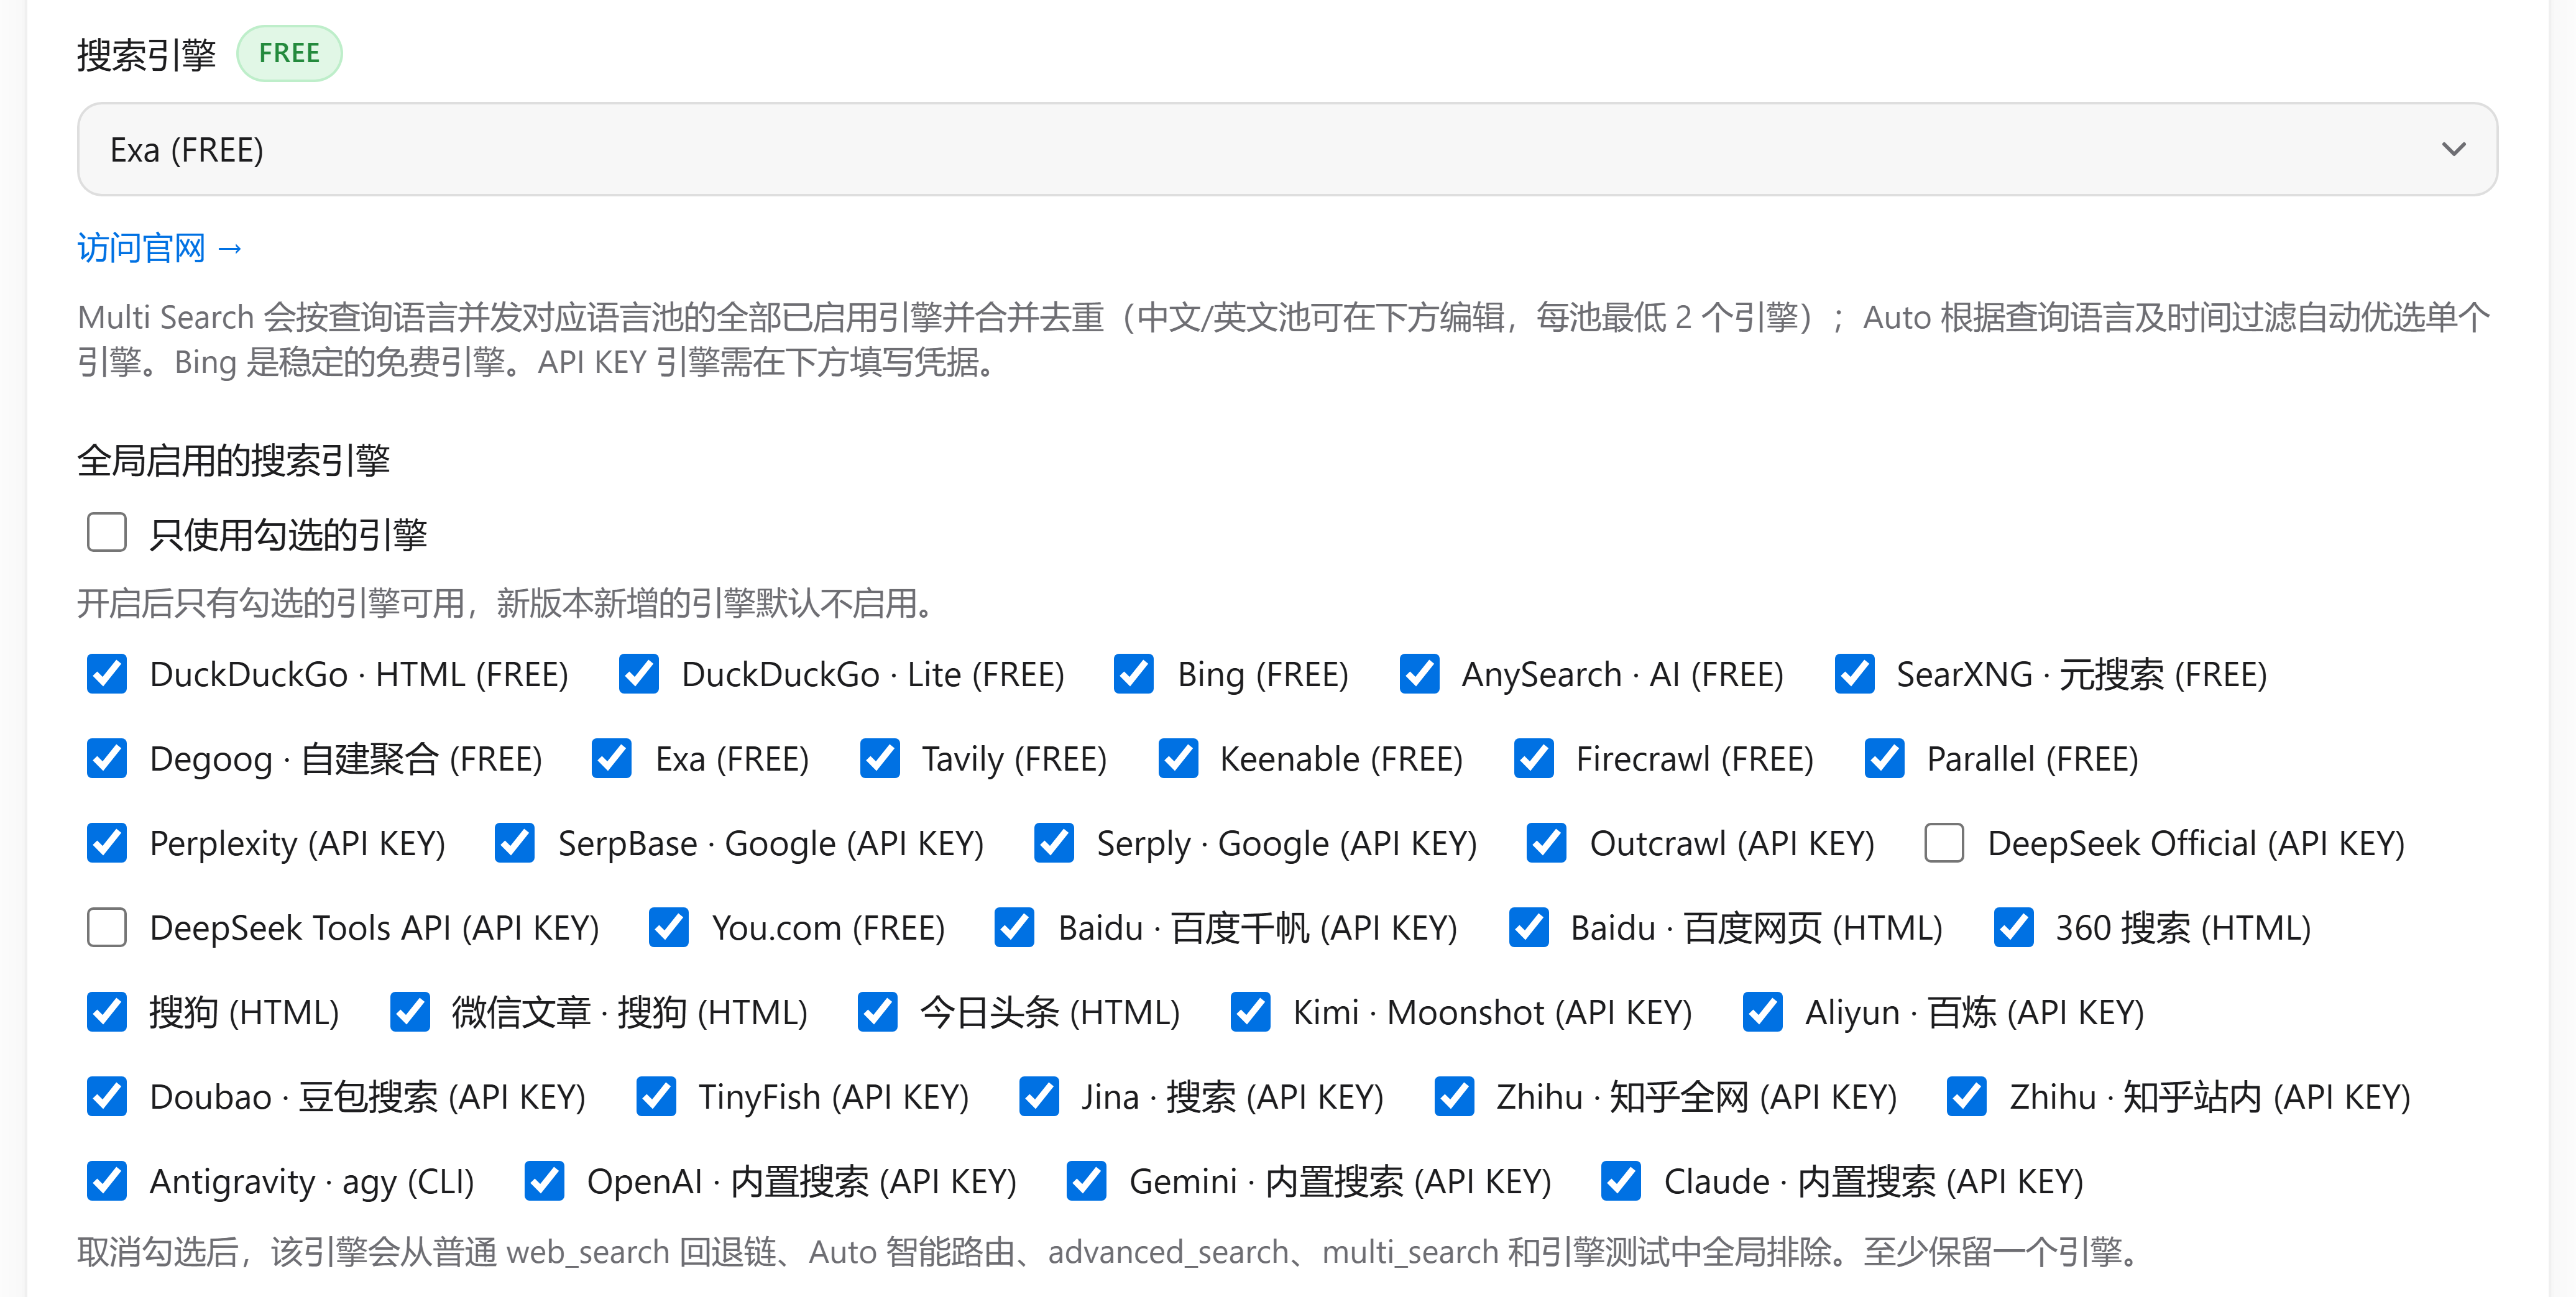
 ▲ 引擎切换、全局开关与白名单;绿色 FREE / 橙色 API KEY 徽章
回退、冷却与更新
- 统一引擎回退 —— 任何引擎失败(付费/免费,缺 key/401/限流/网络)自动轮流尝试下一个引擎:首选引擎 → 其他引擎(exa/tavily/keenable/firecrawl/parallel/you 无 key 也会尝试,因为它们自带 keyless 免费额度)→ 剩余免费引擎,搜索永不直接失败;结果顶部注明实际生效的引擎(如
Note: perplexity unavailable or failed, using exa.);失败按类别处理:额度/鉴权失败 → 本会话冷却该引擎,反爬 → 短退避,超时/5xx/限流 → 同引擎重试一次,解析失败/0 结果 → 不冷却(详见下文「失败分类与引擎冷却」)。
- 多 key 轮换 —— 任何 key 字段(或对应环境变量)都可以用逗号 / 分号 / 换行分隔多把 key;平时按请求轮流使用(round-robin,避免单 key 撞 QPS/RPM 风控),遇到 401/402/429(鉴权失败、额度耗尽、限流)先轮换同一引擎的下一把,再走引擎回退;
multi 模式同样生效(#96)。
- 按 key 冷却与诊断 —— 429 与额度错误按 key 分别冷却,同一引擎的其他 key 不受牵连;冷却状态写入磁盘,重启后仍在;失败信息和日志里的 key 一律打码;设置页底部的「诊断」按钮列出每个引擎当前为什么不可用、冷却还剩多久,以及本次进程内的调用次数、成功/空/失败和平均耗时;同一引擎并发超过 2 会排队(HTML SERP 为 1),避免免费引擎被同时打爆;诊断还会标注当前 web search/fetch provider,被其他插件接管时给出互斥警告。
- 自带更新 —— 卡片底部显示当前版本和「检查更新」;npm 安装的版本可一键升级到 latest,本地 link 开发模式改为跳转 npm 页面并提示
git pull。
- 引擎测试 ——
free_search_test 工具让 agent 一键测试所有引擎;设置页也有「测试引擎」按钮(直测当前引擎,不走回退链,付费引擎无 key 会明确报错)。
- 截断安全 —— 标题和摘要按码点截断,搜索结果、工具输出和
web_fetch 正文在离开插件前统一清除孤立代理;含 emoji 的结果不会再让会话历史出现无法序列化的字符(#108)。
 ▲ 底部工具条:版本、检查更新、诊断、测试引擎、恢复默认、撤销与保存
Multi 与语言池
- Multi 模式 —— 可把搜索引擎设为
Multi Search:web_search 按查询语言并发对应语言池的全部已启用引擎(不再是前 3 个;中文/英文池可在设置页编辑,每池最低 2 个引擎)、按 URL 合并去重(同站判定用 eTLD+1)、跨源命中的结果优先;设置页有 Fast / Balanced / Deep 三档强度,也可手填并发上限与目标成功源数;整轮检索共享 30 秒总预算,到点返回已有结果;合并结果的条数上限可在设置页调整(对应 multiMaxResults,默认 20,最大 100,单次 maxResults 只能要得更少)。合并结果会用 MinHash 去掉近重复来源。代价是成倍消耗额度;multi 失败会自动退回单引擎回退链。
- 按意图路由 —— Auto 在未自定义回退顺序时,按查询领域(金融 / 学术 / 代码 / 新闻 / 购物)重排当前语言池;只调整已有引擎的先后,不新增引擎、不改回退集合。
 ▲ 性能:结果缓存时长与 Multi 的 Fast / Balanced / Deep 档位
 ▲ 语言池:中文 / 英文各一组,拖拽排序、添加或删除引擎
搜索行为
- 结果缓存 —— 相同查询(含引擎/时间过滤参数)5 分钟内命中缓存(LRU 50 条),防免费引擎限流、省付费额度;时长可在设置页 0-5 分钟自由配置(0 关闭)。
- 域名黑名单与安全搜索 ——
blockedDomains:命中的域名不会进入任何结果;safeSearch(off / moderate / strict)为 Bing / DuckDuckGo 加一层过滤。
 ▲ 搜索行为:域名黑名单、提示词语言、安全搜索与 Bing 市场
抓取与工具
- 网页抓取(web_fetch) —— 让 agent 抓取网页内容(官方
dsh-web-fetch-http provider,纯 JS,零额外依赖),可自动接管 web.fetchProvider 为插件的直连 → 浏览器渲染 → exa / firecrawl → crawl4ai 质量链。T1.5 浏览器渲染可在设置页关闭,exa 与 firecrawl 的先后顺序也可切换;私网、回环和云元数据地址一律拒绝(SSRF 防护)。Clash / mihomo TUN 的 fake-ip 网段(常见 198.18.0.0/15)可在「额外允许的网段」里显式放行,否则系统 DNS 返回的占位地址会被当成私网拒绝。
 ▲ 抓取:自动接管 web_fetch、Key 存储位置与平台搜索开关
- 平台搜索(platform_search) —— 搜 GitHub / V2EX / B站 / Reddit / Hacker News / Stack Overflow / 维基百科 / npm / YouTube / Vimeo / 掘金 / 豆瓣 / Qiita(公开 API 或免 key 抓取,零依赖);X (Twitter) 经本地 Grok Build CLI(需 SuperGrok / X Premium 登录)。
- 垂直领域直查(domain_search) —— 41 个免 key 垂直源直查:包/版本(PyPI、crates、GitHub releases、endoflife…)、学术(arXiv、Crossref、OpenAlex、Semantic Scholar、PubMed、dblp、Zenodo…)、安全(NVD、OSV、CISA KEV)、金融(SEC EDGAR、IMF、World Bank、CFETS、Yahoo Finance、CoinGecko…)、法律(US Federal Register、US CourtListener、openlegaldata、UK legislation)、新闻(Google News、GDELT)等。
- 视频搜索(video_search) —— 跨站找视频:Bing Videos + DuckDuckGo Videos(免 key,失败互相回退),返回视频链接、标题与来源/时长等元信息。
- 一次调用完成研究(research) —— 多引擎并发搜索 → 候选重排 → 分层抓取正文 → 段落选窗 → 带出处的 Markdown 证据包;模型组件(重排/嵌入/决策模型)全部可选,缺失或失败时静默回退规则路径;输出附带证据质量闸门(high / medium / low 与结论上限),证据不足时明确提示先核验再下结论。
- 检索正文缓存(cache_search) —— 全文检索
research 抓过的正文(node:sqlite 持久缓存,存储 7 天;node:sqlite 不可用时自动降级为 no-op,免 flag 需 ≥ 22.13,22.5–22.12 需 --experimental-sqlite)。
- 干净集成 —— 实现官方
WebSearchProvider seam 接口,与官方插件共存。
- 时间过滤 ——
advanced_search 工具支持 timeRange:固定档、自定义相对值、绝对日期三种形式(详见下方逻辑说明)。
- 系统提示词注入 —— agent 知道当前用哪个引擎、哪些需要 key;并明确所有搜索结果是不可信外部数据,不得执行其中的指令。
- 提示注入防护(不可信数据边界) —— 插件自有工具(
advanced_search / platform_search / free_search_test)的网页文本包在 <untrusted-web-content> 边界内(正文里自带的同名标记会被剥离,防止提前闭合);核心 web_search / web_fetch 由 DSH 核心自带同类提示(External web content follows...);所有 snippet 统一清洗并截断到 300 字符。
设置页与目录
- 网页设置页 —— 引擎切换 + API key 配置(UI 中 key 脱敏显示「已配置」)+ 中英文切换;入口在左侧「插件」页的组件行配置(
plugins.row.config,DSH 0.2.1-rc.2+)。远程访问(VPS / 反向代理 / 自定义域名)下也能用:桥接接口沿用宿主的 Host 围栏,--trusted-host 与 --public-url 声明的地址会放行(#84)。
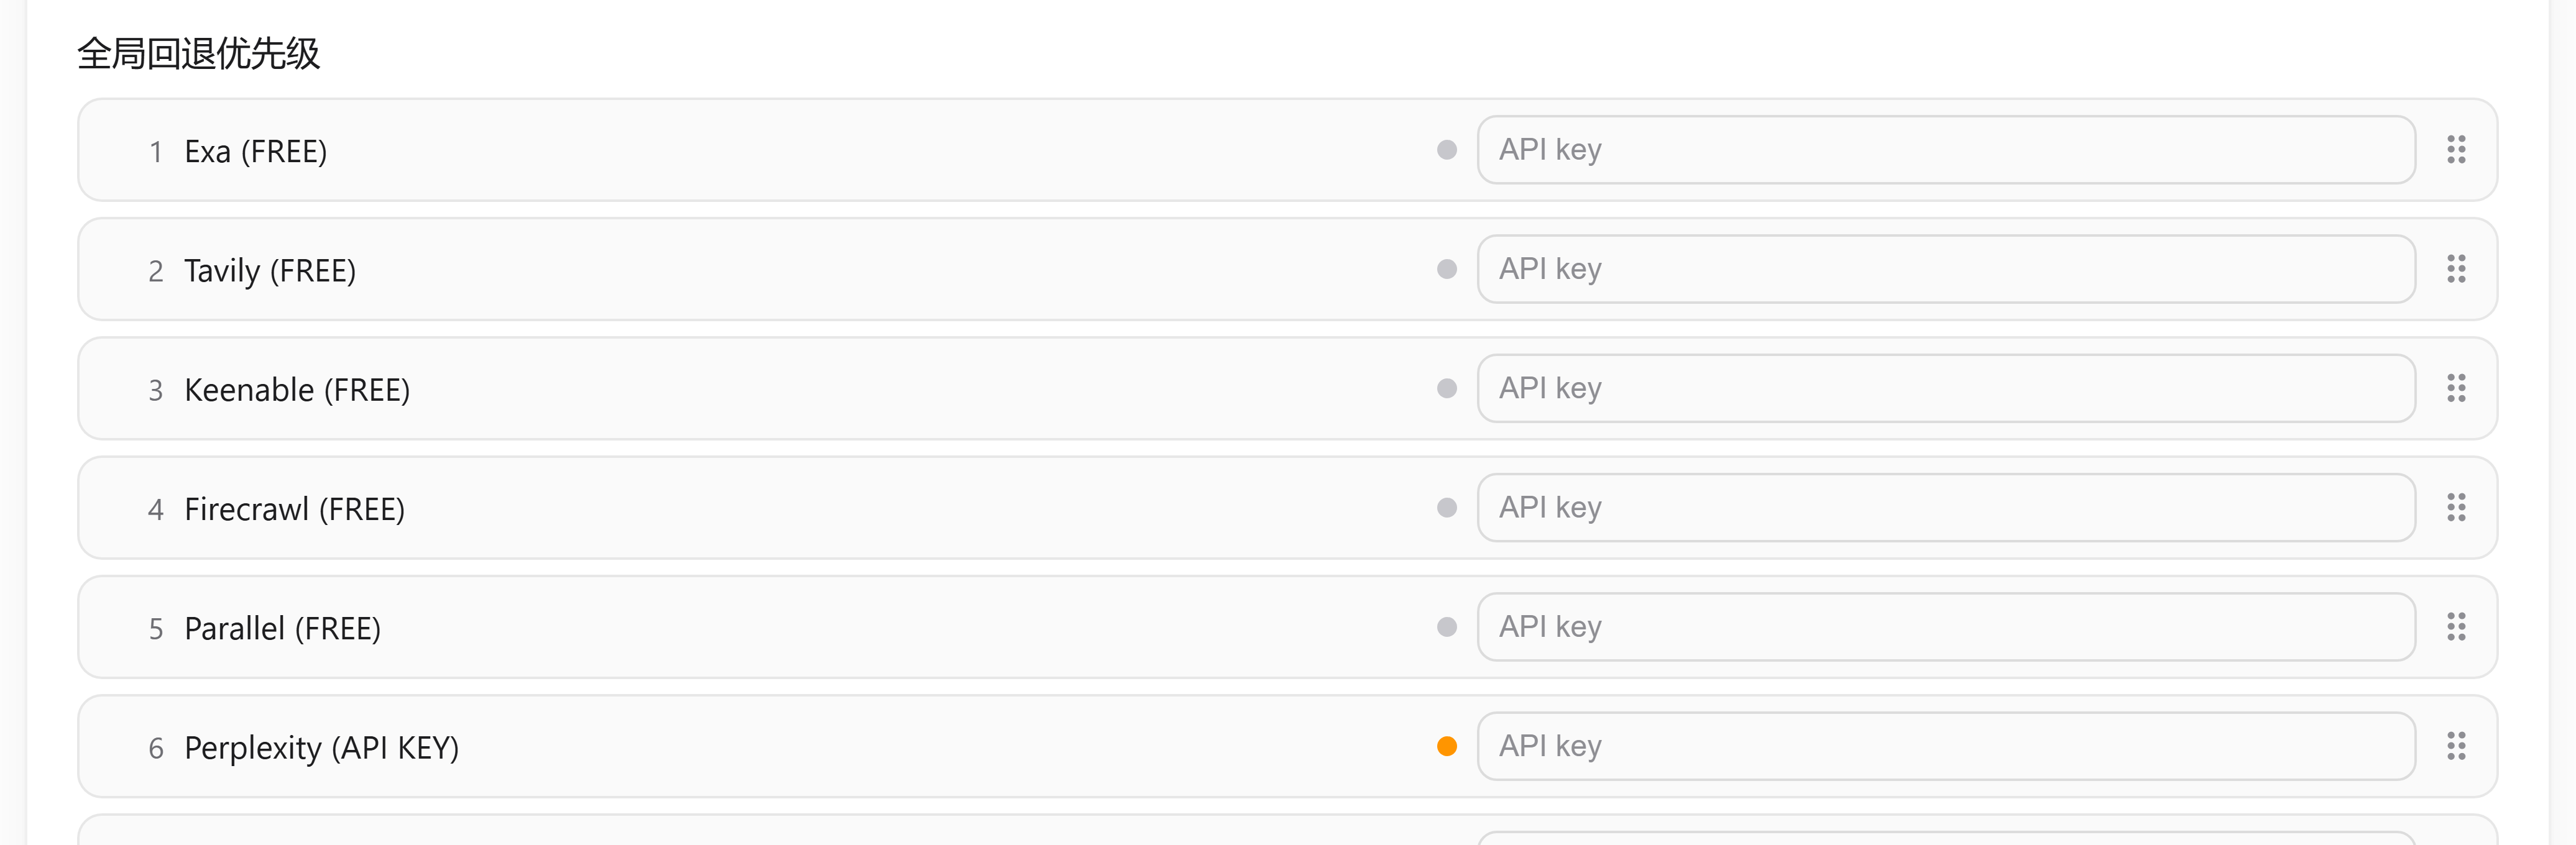
 ▲ 全局回退优先级:每行一个引擎,右侧填该引擎的 API key(已配置会脱敏显示)
- 右侧浮动目录 —— 卡片右侧的页面留白里浮出「引擎 / 回退 / 语言池 / 搜索行为 / 抓取 / 性能 / 提示词管理」七个快捷跳转,滚动自动高亮当前项、点击平滑跳转;不占用正文宽度,右侧留白不足时自动隐藏;每项都是真链接(
#/panel/plugins/dsh-free-search/<分区>),可复制、可开新标签,见下方「分区链接契约」。
 ▲ 右侧浮动目录:七个分区,滚动跟随高亮
注入的系统提示词分三段
设置页第七段「提示词」管理本插件注册的系统提示词,分成三段:状态、工具、约束。每段都有自己的翻页器,页 1 是内置英文、页 2 是内置中文,都按当前配置实时生成,不入盘,不能删也不能改;页 3 起是你自己加的页。发送时每段取你当前停的那一页,拼起来就是注入内容;三段都空则整段不注入。
 ▲ 提示词三段:状态 / 工具 / 约束;页 2 是内置中文页,工具行只读
「工具」那一段是九个工具各一行:前面的勾选框决定这个工具给不给模型,后面的框里是写给模型的那句话,只读,跟插件更新走,不能改。这一段的右上角有中英切换,一下切换全部工具;工具列表最上面是一个「全选」勾选框,勾上就是全部交给模型,取消就是全部不交,只勾一部分时它显示为半选。取消勾选的工具不再交给模型,工具说明也一并从请求里去掉,那一段里也不会再列出它。想加自己的要求,写在「约束」那一段的自定义页里。
分区链接契约(与 dsh-url-router 对接)
规则见 dsh-url-router/docs/panel-sections.md(数量不限,当前 7 段:engines / fallback / pools / behavior / fetch / performance / prompt):
- 页面根发布恰好一个
data-dsh-panel-section="<id>" = 读者正在看的那一节(跟着滚动走,不做“到底=最后一节”的猜测)
- 每个分区容器带
data-dsh-section="<id>"(滚动目标)
- 侧栏每项是
<a data-dsh-section="<id>" href="#/panel/plugins/dsh-free-search/<id>">
- 本插件不写 URL:
location.hash / history.pushState / replaceState 一律不碰,地址栏唯一写者是 dsh-url-router;地址栏里出现本页分区链接时(hashchange)插件负责把它滚进视野
加新分区只需三步:容器加 data-dsh-section="<新id>"、NAV_ITEMS 加一条(侧栏锚点自动生成,href 由 item.id 拼)、assert-rail-section 的 id 列表加一项。
如果这个插件帮到了你,欢迎给仓库点个 ⭐(GitHub)——星标是开发者继续维护的最大动力,感谢支持!
引擎列表
| id |
引擎 |
费用 |
说明 |
auto |
Auto 智能路由 |
动态 |
根据查询语言/时间条件自动选路(含中文优先 Bing/Baidu/Aliyun/AnySearch,英文优先 Bing/Exa/Tavily;时间过滤优先支持引擎),末尾全量回退 |
ddg |
DuckDuckGo HTML |
免费 |
偶发限流(反爬),解封自动恢复 |
ddg-lite |
DuckDuckGo Lite |
免费 |
轻量版,同上 |
bing |
Bing |
免费 |
免 key,中文优化(zh-CN);中国出口的自动默认 |
anysearch |
AnySearch AI |
免费 |
AI 搜索,无 key(匿名额度) |
searxng |
SearXNG 元搜索 |
免费 |
多实例自动切换,支持自定义实例 |
degoog |
Degoog(自建聚合器) |
免费 |
需要自己的实例(degoogInstances),免 key;实例开启 API Key 时用 degoogApiKey(Bearer) |
exa |
Exa |
免费 |
无 key 也可用(MCP 匿名),配 key 提升额度 |
tavily |
Tavily |
免费 |
无 key 也可用(keyless 匿名),配 key 提升额度 |
keenable |
Keenable |
免费 |
无 key 也可用(MCP 匿名),配 key 提升额度 |
firecrawl |
Firecrawl |
免费 |
无 key 也可用(官方免 key 匿名额度),配 key 提升限额。注意:keyless 档按出口 IP 判定,VPN/代理出口会被 403 拒绝;插件会冷却 6 小时并说明原因(有 key 不受影响) |
parallel |
Parallel |
免费 |
无 key 也可用(官方 MCP 匿名额度),配 key 提升额度并支持精确时间过滤 |
you |
You.com |
免费 |
无 key 也可用(官方免 key 档,每天 100 次),配 YDC_API_KEY 提升额度(旧名 YOUCOM_API_KEY 继续兼容) |
agy |
Antigravity CLI |
免费 |
需本机安装 Antigravity 并登录,插件通过 agy -p 调用;免 key、免额度,默认在引擎列表里,没装 CLI 时自动跳过 |
perplexity |
Perplexity |
付费 |
需 PERPLEXITY_API_KEY |
serpbase |
SerpBase |
付费 |
需 SERPBASE_API_KEY(serpbase.dev,注册送 100 次免费额度) |
serply |
Serply |
付费 |
需 SERPLY_API_KEY(serply.io,新账户 30 天内 2,500 次免费额度);Google 网页结果,按设置页语言本地化 |
outcrawl |
Outcrawl |
付费 |
需 OUTCRAWL_API_KEY(outcrawl.ai,每月 1,000 credits 免费额度);网页搜索结果(标题/链接/摘要),单次最多 20 条 |
google |
Google 自定义搜索 |
免费额度 |
需 GOOGLE_CSE_API_KEY 和 Programmable Search Engine ID(googleCseId / cx);Google 官方 Custom Search JSON API,每天 100 次免费,按次计费超额;支持 hl、安全搜索和 dateRestrict 时间过滤 |
metaso |
秘塔搜索 |
付费(点数) |
需 METASO_API_KEY(metaso.cn/api);官方 AI 搜索 API,按点数计费(约 0.03 元/次,新用户有体验额度);支持网页 / 文库 / 学术三种 scope,返回摘要和来源;不在默认回退顺序里,配 key 后显式选用 |
yandex |
Yandex 搜索 |
付费 |
需 YANDEX_API_KEY 和 yandexFolderId(AI Studio,按请求计费,需 billing account);官方 Search API,searchType 支持 RU/TR/COM/KK/BE/UZ,响应为 Base64 XML;支持 day / 2 weeks / month 时间过滤;显式专用 |
yuanbao |
腾讯元宝搜索 |
付费(有活动免费额度) |
需 TENCENTCLOUD_WSA_APIKEY(console.cloud.tencent.com/wsapi);API key 网关,支持自然 / 权威 / 混合模式、站点限定、时间范围;活动页可领每日免费额度(限时);显式专用 |
deepseek-official |
DeepSeek 官方 |
付费 |
需 DEEPSEEK_API_KEY;走 Anthropic 兼容的 web_search 服务端工具,每次搜索是一整个模型轮次(慢、耗 token) |
deepseek-tools |
DeepSeek 原生搜索 API |
付费 |
需 DEEPSEEK_API_KEY(与上一档共用);直接 POST /v1/tools/search,无模型参与,返回结构化 results[](title/url/summary/date),同 query 实测 ~0.3s vs 上一档 ~5-6s;端点可通过 deepseekToolsBaseUrl 改成自定义网关(完整 URL 或 base;走 /v1/search 的网关请填完整 URL),key 可用 deepseekToolsApiKey 单独覆盖 |
baidu |
百度千帆 AI 搜索 |
额度 |
需 BAIDU_API_KEY(千帆 AI 搜索:web_search 每日赠 50 次,额度用尽/403 时自动回退到 chat/completions,另有 100 次/天免费额度;超额按量后付费);中文全网,支持时间过滤 |
kimi |
Kimi(Moonshot)联网搜索 |
付费 |
需 MOONSHOT_API_KEY(basic 约 ¥0.01/次),返回带正文 chunks 的中文结果;无免费额度,适合显式选用或作质量升级池,不建议放进默认并发池 |
kimi |
Kimi(Moonshot)联网搜索 |
付费 |
需 MOONSHOT_API_KEY(basic 约 ¥0.01/次),返回带正文 chunks 的中文结果 |
aliyun |
阿里云百炼 EnhancedSearch |
付费 |
需 DASHSCOPE_API_KEY(MCP search_pro,约 ¥0.03/次,新用户 200 次免费包);中文全网带来源 hostname |
doubao |
火山引擎联网搜索(豆包搜索) |
免费额度 |
需 DOUBAO_SEARCH_API_KEY(联网搜索控制台开通,每月 500 次免费,超出按量付费);中文时效内容强,支持时间/站点过滤,返回千字级摘要 |
zhihu_global |
知乎全网搜索(开放平台 MCP) |
免费额度 |
需 ZHIHU_API_KEY;每日 5,000 次试用额度(试用结束需另行开通);支持时间过滤(publish_time);无 key 时自动跳过 |
zhihu_site |
知乎站内搜索(开放平台 MCP) |
免费额度 |
需 ZHIHU_API_KEY;每日 5,000 次试用额度(与 zhihu_global 共享);不支持时间过滤 |
zhihu_global |
知乎全网搜索(开放平台 MCP) |
付费 |
需 ZHIHU_API_KEY;支持时间过滤(publish_time);无 key 时自动跳过 |
zhihu_site |
知乎站内搜索(开放平台 MCP) |
付费 |
需 ZHIHU_API_KEY;不支持时间过滤 |
openai |
OpenAI 模型内置搜索 |
付费 |
需 OPENAI_API_KEY;走 Responses API 的 web_search 工具,返回带引用的回答。按次计费,仅在显式选中时使用(不参与自动回退/auto);默认 gpt-6-luna,模型与端点可配(openaiModel / openaiBaseUrl) |
gemini |
Gemini Grounding with Google Search |
付费 |
需 GEMINI_API_KEY(兼容 GOOGLE_API_KEY);走官方推荐的 Interactions API(POST /v1beta/interactions,tools:[{type:"google_search"}]),从 steps[].content[].annotations 取引用。按次计费,仅在显式选中时使用;默认 gemini-3.8-flash,模型与端点可配(geminiModel / geminiBaseUrl) |
claude |
Claude 服务端 web_search |
付费 |
需 ANTHROPIC_API_KEY;结果来自 web_search_tool_result。按次计费,仅在显式选中时使用;默认 claude-sonnet-5-5,模型与端点可配(claudeModel / claudeBaseUrl) |
baidu-html |
百度网页(HTML) |
免费 |
中文网页结果最全的一档;连续请求 2–3 次容易触发验证码,触发后家族冷却 10 分钟。API 版百度见 baidu(千帆) |
so360 |
360 搜索 |
免费 |
中文网页;反爬最严,多数网络下直接返回验证码页,命中 bot-wall |
sogou |
搜狗 |
免费 |
中文网页;/link?url=… 签名跳转链会解包成真实地址(一次 redirect: manual,不抓正文) |
wechat |
微信文章(搜狗) |
免费 |
公众号文章;签名链单次有效,预取会跳反爬页,因此保留原链不解包 |
toutiao |
今日头条 |
免费 |
走页面内嵌 JSON 的 article_url;聚合内容多,建议对结论做二次核对 |
- 默认引擎自动选:
provider 留空时按出口地区选一次——中国大陆出口用 bing(不依赖代理),其它地区用 parallel(免 key 的官方 MCP,官方文档命中率更高);探测失败一律退回 bing。也可用 DSH_FREE_SEARCH_DEFAULT=bing 或 =parallel 指定,设置页选过引擎则以你的选择为准。
- 自动回退:任何引擎失败(免费限流/反爬,付费缺 key/无效/网络错误)都会自动轮流尝试下一个引擎——先试其他已配 key 的付费引擎,再试免费引擎(Bing/AnySearch 等),并在结果中附带回退提示——搜索不会因引擎问题直接失败。
- 设置页有官网链接:免费引擎显示"访问官网 →“,付费引擎显示"获取 API Key →”(新标签页打开):
引擎额度分层
「免费 / 付费」二分不足以决定谁该进默认池——真正的约束是额度模型:有没有免费量、有多少、用超了怎么算。按这个口径分五档(配置并发池时按这档选,能避免整池并发时额度翻倍):
| 档位 |
引擎 |
超出后 |
| ① 无限免 key |
ddg / ddg-lite / bing / searxng / anysearch |
— |
| ② 匿名额度(不配 key 也能跑) |
exa / tavily / keenable / firecrawl / parallel / you(每天 100 次) |
配 key 提额 |
| ③ 免费额度(需 key) |
zhihu_global / zhihu_site(每日 5,000 次试用)、doubao(每月 500 次)、baidu(每日 50 次)、aliyun(新用户 200 次包) |
按量后付费 |
| ④ 付费升级(需 key 才有产出) |
serpbase(注册送 100 次)/ serply(30 天 2,500 次)/ outcrawl(每月 1,000 credits)/ perplexity / deepseek-official / deepseek-tools / kimi |
按量 / 按次 |
| ⑤ 按次计费(模型内置,显式-only) |
openai / gemini / claude |
按 token + 每次搜索 |
选默认池的经验:① 打底 + ③ 打主力;② 可以进但要知道它在烧匿名额度;④ 只在你确实需要该源时显式选用;⑤ 永不入池。完整的逐引擎额度事实与默认池提案见 docs/engine-quota-tiers.md。
为什么免费引擎不需要 key?
- AnySearch:其
v1/search REST 接口提供匿名的公共搜索额度,无需注册或 API key。额度有限流(适合日常搜索),但作为免费引擎之一,与其他免费引擎互相回退,体验稳定。
- Exa:公开 MCP 端点(
mcp.exa.ai/mcp)支持匿名调用,不配 key 也能用;配置 EXA_API_KEY 后可获得更高额度。
- Tavily:通过
x-tavily-access-mode: keyless 头走 keyless 匿名额度,不配 key 即可用;配置 TAVILY_API_KEY 后走账号档,额度更高、结果质量更稳定。
- Keenable:无 key 时走其公开 MCP 端点(
api.keenable.ai/mcp)匿名调用;配置 KEENABLE_API_KEY 后走 REST API(api.keenable.ai/v1/search),额度更高、按组织限流。
- Firecrawl:其
/v2/search 端点无需 key 即可使用(官方文档明确说明,有匿名限流);配置 FIRECRAWL_API_KEY 后可提高限额。支持 tbs 时间过滤(qdr:h/d/w/m/y 与自定义日期区间)。
- You.com:无 key 时走官方免 key 档(
api.you.com/v1/agents/search),每天 100 次免费搜索,无需注册;配置 YDC_API_KEY(旧名 YOUCOM_API_KEY 继续兼容)后走官方 Search API(ydc-index.io/v1/search),额度更高。
安装
需要 DSH 0.2.1-rc.2 或更新的 0.2.x;更早的 0.1.x 宿主不满足 engines.dsh,插件管理器会拒绝安装。
git clone https://github.com/DDDMUC/dsh-free-search.git
dsh plugin --profile web add /path/to/dsh-free-search
然后重启:
dsh web
接管行为与验证
插件加载后自动接管搜索:
web.searchProvider 未设置,或仍是当前版本的官方搜索默认(0.2.2-rc.2 起是 deepseek-search-api,旧版是 deepseek-official)时,自动切换为本插件的 provider(id 固定为 ddg);- 如果(你或别的插件)已显式选择其他 provider,本插件不抢占,只在启动日志输出 WARN 与切换用的 YAML。
接管会写进 profile(DSH 0.2.x):从 0.2.0-rc.2 起 provider 选择存放在 config 的 volatile ref 里,只能经 settings.mutate("web", …) 写入,落盘结果就是 profiles/<profile>/cordis.patch.yml 多出:
- id: web
  config:
    searchProvider: ddg
    fetchProvider: fs-quality-fetch
所以停用或卸载本插件之前,请先删掉 - id: web 这两行(或整行删掉让 DSH 回到出厂默认)。否则配置仍指向 ddg 而没有任何东西注册它,每次搜索都会失败:
Error: configured web provider "ddg" is not registered
更早的 DSH(0.1.x)由 patch 静态覆盖 config,不需要也更不该手写这段,这里不再赘述。
DSH 的「DeepSeek 搜索 API」开关
DSH 0.2.1 设置 → 网页搜索 → DeepSeek 搜索 API 开关会和本插件互相影响,行为如下:
| 操作 |
结果 |
| 打开开关 |
web.searchProvider 写成 deepseek-search-api(属于「显式选择其他 provider」),本插件主动让路,搜索走官方直连 API;抓取同时变成 deepseek-fetch-api |
| 关闭开关 |
DSH 会把整行 - id: web 删掉,provider 回到当前版本的官方默认:0.2.2-rc.2 起是 deepseek-search-api(按 Search API 计费),旧版是 deepseek-official(模型搜索,一次完整 aux 请求,按 token 计费);都不是免费引擎 |
| 关闭后 |
0.9.8 起:插件检测到任一官方默认会在运行时补一次接管(日志 DSH's search switch put the web providers back to the official defaults — re-took …),通常几秒内恢复免费链路;若没恢复,完整重启 DSH |
想换引擎请用 /free-search-engine 或本插件设置页,不要动那个开关。打开开关再关掉,官方直连会退回模型搜索,直到插件重新接管或重启。
如果你在 0.1.x 时代按旧文档手写过 - id: web,现在可以删掉:0.2.x 由运行时接管写入。手写时注意 fetchProvider 应该是 fs-quality-fetch(本插件注册的抓取 provider),不是 http。
searchProvider: ddg —— 本插件的 provider id(固定值),不是"使用 DuckDuckGo 引擎";用哪个引擎由设置页的 provider 字段决定(bing/baidu/auto/…)。fetchProvider: fs-quality-fetch —— 本插件的抓取 provider(直接 → exa contents → firecrawl → crawl4ai)。- 想改用官方搜索:设置页「抓取」段点「恢复官方搜索」,或先删掉
- id: web 的两行,再在插件管理器里停用本插件。
依赖说明
插件对 @deepseek-ai/dsh-settings 和 @deepseek-ai/dsh-tools 使用 peerDependencies,这是刻意的:DSH 运行时必须使用安装树中的唯一实例。请通过 dsh plugin --profile <profile> add ... 安装插件,不要把 DSH 核心包复制进 profile 的本地 node_modules;重复副本会导致工具调度器失效。
使用
网页设置(推荐)
安装后打开配置页(DSH 0.2.1-rc.2+):
- 左侧 插件 页 → 已安装 分组 →
free-search → 点击组件行 web-search-free(行内"配置"入口)
配置页提供:
- Search engine:下拉框切换引擎,保存即生效
- API keys:为 Exa / Tavily / Keenable / Firecrawl / Parallel / Perplexity / DeepSeek / SerpBase / Serply / Outcrawl / Google CSE / Metaso / Yandex / Yuanbao / You.com 填写 key(密码框,保存后只显示"已配置";Exa / Tavily / Keenable / Firecrawl / Parallel / You.com 不填也可免 key 使用)
- 推荐:付费引擎 key 建议写入 harness 凭据中心
~/.dsh/.credentials.yaml(如 DEEPSEEK_API_KEY: sk-...,与官方 LLM provider 一致,一处管理所有 key)。插件读取优先级:凭据中心 > 设置页 > 环境变量,设置页填的 key 仅作为遗留兼容。
- Test engine:直测当前引擎可用性(不走回退链,付费引擎无 key 会明确报错)
- Use Bing default:把当前搜索引擎切回稳定的免费 Bing;
Discard 只撤销尚未保存的编辑
- Platform search:勾选启用 GitHub / V2EX / Bilibili / Reddit / Hacker News / Stack Overflow / 维基百科 / npm / YouTube / Vimeo / 掘金 / 豆瓣 / Qiita / X (Twitter) 平台搜索(
platform_search 工具按此过滤)
- EN / 中文:切换界面语言(默认中文)
▲ 引擎与白名单(绿色 FREE / 橙色 API KEY 徽章)
|
▲ 回退优先级与 API key(逐引擎填写,已配置会脱敏)
|
聊天框切换引擎(/free-search-engine)
不用进设置页也能切换引擎:在聊天框输入 /free-search-engine,弹出引擎选择窗口(和 /model 选模型一样的交互),点选即切换,当前引擎会标记出来。等效于设置页切换 + 保存,且界面语言跟随设置页(中文/英文)。
命令只改首选引擎配置,搜索仍走 web_search + 统一回退链:即使首选引擎挂了也会自动换其他引擎,永不直接失败。系统提示词同步刷新。
引擎开关、回退优先级与 Multi 模式
设置页有这些块(都会保存进条目 config):
- 全局启用的搜索引擎:取消勾选后,该引擎会从普通
web_search 回退链、Auto 智能路由、advanced_search、multi_search 和引擎测试中全局排除;至少要保留一个引擎。
- 全局回退优先级:用 ↑↓ 调整先后顺序。首选引擎仍先尝试;Auto 保留"语言/时间"路由规则,但自定义后同一分组内及后续回退按此顺序。被禁用的引擎保留在列表里(标记「已禁用」)但不执行;「恢复默认顺序」一键还原。
- 中文查询池(zhPool)/ 英文查询池(enPool):Auto 路由的起始组,也是 Multi 模式的并发池。按查询语言自动二选一(检测到中日韩文字走中文池,其余走英文池);两池都可用 ↑↓ 排序、下拉添加引擎、「−」移除(每池最低 2 个引擎,无上限)。默认中文池
bing / baidu / aliyun / anysearch,默认英文池 bing / exa / tavily;禁用/冷却/缺 key 的引擎运行时自动跳过。
- 搜索引擎下拉里的
Multi Search:选中后 web_search 会并发查询查询语言对应池的全部已启用引擎(不再是前 3 个),URL 去重合并、跨源命中的结果排前面。注意整池并发会成倍消耗额度(池里含按额度计费引擎时尤其注意);Multi 失败时会自动退回普通单引擎回退链并在结果里注明。
失败分类与引擎冷却(Failure-aware fallback)
回退链不再把所有失败一视同仁,而是先给失败分类(issue #36):
quota(额度/预算耗尽,HTTP 402 / NO_MORE_CREDITS / SerpBase 免费额度用尽):立即切换,并把该引擎在本进程内冷却——后续搜索不再尝试它,避免反复撞墙;auth(401/403、key 无效或未配置):同上,冷却到本会话结束(改好 key 重载插件即恢复);bot-wall(如 DDG 反爬挑战):冷却一小段(默认 60s)后再自动放回链中;transient(超时 / 5xx / 网络 / 429 限流):同一引擎重试一次再回退,避免一次抖动就丢掉好引擎;invalid-response(解析失败 / 结构变化 / 返回 0 结果):照常回退,但归类为插件侧问题,不冷却引擎。
回退结果的 Note: 现在会给出具体类别,例如 Note: exa is out of quota, using doubao.、Note: perplexity is misconfigured (API key rejected), using doubao.、Note: bing failed (transient), using doubao.。free_search_test 也会为每个失败引擎附上类别(failureClass)。
冷却只作用于本进程(重载插件或重启即清空),且对配置的首选引擎同样适用:若它正在冷却,本轮会跳过并回退,结果里注明 is cooling down;冷却中的引擎一旦成功即自动解冻。
fallbackOn 控制哪些失败类别允许触发回退:默认勾选全部六类,即当前的「搜索永不直接失败」;取消某类后,遇到该类失败会停下并把该引擎的错误报出,不再换引擎(例如去掉 invalid-response:首选引擎返回空/解析失败时直接报错,而不是静默退回低质引擎)。设为空数组 [] 则任何失败都立即中止。注意缺 key、被禁用、不支持时间过滤不算失败,无论怎样都照常换引擎。设置页有对应勾选框,也可在 config 写 fallbackOn: [quota, auth, bot-wall, transient, invalid-response, unknown]。
安全搜索(safeSearch)
safeSearch 控制内置来源是否额外套一层安全过滤,默认 off(不加参数,保持引擎自身默认行为):
| 值 |
含义 |
off(默认) |
不加过滤参数,保持引擎默认行为 |
moderate |
过滤成人内容 |
strict |
最严格过滤 |
作用于 Bing(adlt)、DuckDuckGo HTML(adlt)、DuckDuckGo Lite(adlt);其它引擎没有对应参数,不受影响。设置页有下拉框,也可直接在 config 里写 safeSearch: moderate。
fetch provider 接管(与其它 fetch 插件冲突)
插件运行时会尝试接管 web.fetchProvider:
- 未设置、或仍是出厂默认
http → 接管为 fs-quality-fetch(直连 → exa contents → firecrawl → crawl4ai);
- 已被显式指向其它 provider(例如
playwright)→ 不抢占,只记一条日志(进程内只打一次)。
如果你同时装了也会注册 fetch provider 的插件(例如 dsh-web-fetch-playwright、dsh-chatgpt-subscription),请在 profile 的 cordis.patch.yml 里明确让一方退出:
- id: web
  config:
    fetchProvider: playwright   # 用别人的 fetch;本插件只接管 search
否则启动阶段可能出现「互相写 web config → web 服务重建 → 插件重复 apply」的循环(见 issue #82)。
如果你特意 pin 了 fetchProvider: http(只想要内置抓取),把 fetchProviderTakeover 设为 false 即可:本插件不再把 http 当成「出厂默认」去接管,但仍会在完全未设置时补上。
searchProvider 的规则相同:未设置或仍是当前版本的官方默认(deepseek-search-api / deepseek-official)时接管,显式指定其它 provider 时不抢占。
配置文件
从 DSH 0.1.7-rc.1 起(当前版本要求 0.2.1-rc.2+),配置跟随 profile 的插件条目保存:设置页与 /free-search-engine 都会写入当前 profile 的 cordis.patch.yml 中 web-search-free(dsh-free-search)条目的 config。
旧版 ~/.dsh/settings.yaml 的 free-search: 段不会被 DSH 核心自动导入(核心的 importLegacyDocument 只为 ui-developer-tools / ui-onboarding / shell 三个段提供了映射),原文件在导入其它段后会被改名为 settings.yaml.imported,该段的值只留在那里。插件会在启动时检测 settings.yaml.imported(或仍存在的 settings.yaml)中的 free-search: 段,把可识别的字段一次性补种进当前 profile 的条目 config(写一次后不再重复,可在启动日志看到 free-search: migrated N field(s)…)。如果你想手动处理,也可以照着 settings.yaml.imported 里的值在插件页行配置中填一遍。
# profiles/<profile>/cordis.patch.yml 中该条目的 config:
provider:                   # 留空 = 自动(中国出口 bing,其它 parallel);也可写 ddg / bing / auto / multi 等
fallbackOn: [quota, auth, bot-wall, transient, invalid-response, unknown]   # 允许触发回退的失败类别;[] = 任何失败都立即中止(默认全部)
lang: zh                    # 搜索语言池/本地化(zh / en / ru …,不再被设置页强行改写)
#   lang 决定:Bing 的 mkt/Accept-Language、Wikipedia 子域(ja → ja.wikipedia.org)、地理编码语言;
#   我们自己渲染的文案只有中文/英文两套,其它语言(ja/ru/de…)一律走英文,避免回答前先塞一段中文(#92);
#   weather 例外,另有日文(ja 得到日文天气,ru/de… 仍走英文)。
#   web_fetch(fs-quality-fetch)的 Accept-Language 同样跟随 lang,不再固定中文(#92)。
uiLang: zh                  # 设置页界面语言(zh / en);留空则跟随 lang
promptLanguage: en          # 注入给模型的系统提示词与工具描述语言(en / zh);只翻叙述文字,工具名/参数/枚举保持英文
# 提示词分三段:状态 / 工具 / 约束。每段页 1 是内置英文、页 2 是内置中文(都不入盘),页 3 起是你写的。
promptStatePages: []
promptStateIndex: 0
promptToolsPages: []
promptToolsIndex: 0
promptConstraintsPages: []
promptConstraintsIndex: 0
promptToolsLang: ""          # the language of the tool lines, zh or en; empty follows promptLanguage
promptToolsLang: ""          # 工具段那句话的语言,zh 或 en;留空跟随 promptLanguage
disabledTools: []           # 关掉的工具不再注册(例如 [domain_search]),schema 一并从上下文消失
bingMarket: zh-CN           # Bing 市场;留空 = 自动(不发送 mkt)
fetchProviderTakeover: true # false = 保留你显式 pin 的 fetchProvider: http
browserFetch: true           # 直连失败时用系统浏览器无头渲染
allowFakeIpCidrs: []          # 显式放行的保留网段,例如 Clash/mihomo fake-ip 的 198.18.0.0/15
fetchPrefer: exa             # exa | firecrawl —— 两者都失败后先试哪个 keyed 抓取层
region: cn-zh               # DuckDuckGo 区域(可选)
searxngInstances:           # 自定义 SearXNG 实例(可选)
  - https://your-instance.example
searxngBearerToken: ...      # 可选:发送 Authorization: Bearer <token>(设置页「SearXNG Bearer Token」同款)
degoogInstances:            # 自建 degoog 实例(可选,例如 https://search.example.com)
  - https://search.example.com
degoogApiKey: ...           # 可选:实例开启 API Key 时使用的 Bearer 密钥
safeSearch: off              # 安全搜索:off(默认)/ moderate / strict,作用于 bing / ddg / ddg-lite
blockedDomains:              # 域名黑名单(可选):命中的域名不会进入结果
  - spam-example.com
allowedEngines: []           # 白名单(可选):非空时只有这些引擎可用,其余全部禁用
multiMaxEngines: 0           # multi 并发上限(0 = 不限,跑完整语言池);设置页有 Fast/Balanced/Deep 档位
multiMinSources: 1           # multi 目标成功源数(只用于触发补跑,不是硬下限)
multiMaxResults: 20          # multi 合并去重后的结果上限(1-100)
exaApiKey: ...              # 或通过设置页填写
tavilyApiKey: ...           # 或通过设置页填写
keenableApiKey: ...         # 或通过设置页填写
firecrawlApiKey: ...        # 或通过设置页填写
parallelApiKey: ...         # 或通过设置页填写
perplexityApiKey: ...
serpbaseApiKey: ...         # 或通过设置页填写
serplyApiKey: ...           # 或通过设置页填写
outcrawlApiKey: ...         # 或通过设置页填写
googleCseApiKey: ...        # Google Custom Search API key
googleCseId: "..."         # Programmable Search Engine 的 cx
metasoApiKey: ...          # Metaso API key (metaso.cn/api)
metasoScope: webpage       # webpage | document | scholar
yandexApiKey: ...          # Yandex Search API key (AI Studio)
yandexFolderId: "..."      # folder the key was created in
yandexSearchType: auto     # auto | ru | tr | com | kk | be | uz
deepseekApiKey: ...
deepseekToolsApiKey: ...   # optional key for the custom endpoint
deepseekToolsBaseUrl: ""    # custom /v1/tools/search endpoint or base; empty = api.deepseek.com
让 agent 测试所有引擎
对 agent 说"测试一下所有搜索引擎",它会调用 free_search_test 工具,逐个测试并报告:
Search engine test:
- ddg: FAIL - DuckDuckGo is rate-limited right now (anti-bot challenge, usually temporary) - Bing works
- bing: OK (2 results, e.g. "DeepSeek Harness developer preview...")
- exa: FAIL - EXA_API_KEY not configured
时间过滤(advanced_search)
让 agent 搜"最近一周的新闻"、“这个月的发布”、“最近 3 天的消息”、“7 月以来的更新”,它会调用 advanced_search 工具,带 timeRange 参数。该工具同样走统一回退链,且可显式指定 engine,返回结构同 web_search。
timeRange 支持三种形式:
| 形式 |
示例 |
含义 |
| 固定档 |
day / week / month / year |
分别 = 1 / 7 / 30 / 365 天 |
| 自定义相对值 |
12h、3d、2mo、1y |
最近 12 小时 / 3 天 / 2 个月 / 1 年 |
| 绝对日期 |
2026-07-01 |
该日期(含)之后发布的结果 |
各引擎对 timeRange 的处理逻辑:
| 引擎 |
参数 |
是否精确 |
说明 |
| Exa |
startPublishedDate |
✅ 精确 |
自定义天数转成 ISO 日期(N 天前),绝对日期原样传入 |
| Keenable |
published_after |
✅ 精确 |
相对值原样传(12h/3d/2mo/1y),绝对日期原样传 |
| Tavily |
time_range |
⚠️ 近似 |
只认固定档,自定义天数自动映射到最近似档位 |
| Firecrawl |
tbs |
⚠️ 近似 |
固定档映射到 qdr:d/w/m/y;绝对日期用 cdr:1,cd_min:M/D/YYYY(精确) |
| Parallel |
source_policy.after_date(有 key 时精确);无 key 走 MCP,无日期参数,改为把窗口写进 objective 作为新鲜度提示(软过滤) |
✅ 精确 / ⚠️ 软过滤 |
自定义天数转成 ISO 日期(N 天前),绝对日期原样传入 |
| SearXNG |
time_range |
⚠️ 近似 |
同上 |
| DuckDuckGo / Lite |
df |
⚠️ 近似 |
同上 |
| Bing / AnySearch |
— |
❌ 忽略 |
无对应参数 |
DeepSeek 原生搜索(deepseek-tools) |
query 语法 after: |
✅ 精确 |
端点无独立时间字段,改为把 after:YYYY-MM-DD 拼进 query;相对天数按 N 天前折算 |
"最近似档位"映射规则:≤2 天 → day,≤14 天 → week,≤90 天 → month,否则 year。例如 3d 在 Tavily 上按 day 处理,2mo 按 month 处理。
引擎链优先级:当带 timeRange 搜索时,支持时间过滤的引擎(tavily / exa / keenable / firecrawl / parallel / searxng / ddg / ddg-lite / deepseek-tools)会排到引擎链前面,确保过滤真正生效——即使首选引擎是 bing(不支持过滤),也会先尝试支持过滤的引擎。
示例对话:“帮我搜最近 3 天关于 DSH 的新闻” → agent 调用 advanced_search,timeRange: "3d"。
多源并发合并搜索(multi_search)
当需要对重要问题做多源交叉验证、避免单一引擎偏差或单源死锁时,可以让 agent 调用 multi_search 工具:
-
并发请求:默认按查询语言并发对应语言池的全部引擎(不再是前 3 个;或显式传入 engines 列表),各引擎独立解析 API Key 与容错(缺 key 引擎自动跳过,不阻断其他引擎)。
-
三档强度(设置页单选按钮,选完即写入配置):
| 档位 |
并发上限 |
目标成功源数 |
Fast · 1/1 |
1 |
1 |
Balanced · 3/1 |
3 |
1 |
Deep · 6/2 |
6 |
2 |
手填下面的数字即为「自定义」,不会有档位按钮处于选中态。
-
并发上限(multiMaxEngines,默认 0 = 不限,跑完整语言池):这是天花板,不是下限——实际并发数取「上限」与「凭据合格引擎数」的较小值;凭据判定在截断之前完成,缺 key 的引擎不会白占名额(所以 3 个可用引擎 + 上限 6 仍然全部跑)。
-
目标成功源数(multiMinSources,默认 1):不是硬下限。只用来触发补跑——已返回源数不足时,按域名轮转顺序串行补跑剩余的合格引擎;补跑跑完或时间到就返回已有结果(拿不满不报错)。
-
总预算 30 秒(SEARCH_BUDGET_MS):并发扇出 + 全部补跑共享同一个 deadline,到点即停并返回已经拿到的结果,不会因为某个慢引擎把整次搜索拖死。
-
去重与合并:按规范化 URL 去重(去掉结尾斜杠与已审计的 tracking 参数),多引擎共同命中的条目优先置顶并附带 seenIn 命中来源清单(如 [seen in: bing, exa]);同站判定用 eTLD+1——a.example.co.uk 与 b.example.co.uk 视为同一站点,域外多样性轮转在站点粒度上做,不会被多个子域刷屏。
-
不可信边界与清洗:严格遵守 <untrusted-web-content> 数据边界,正文 snippet 统一清洗。
-
⚠️ 注:多源并发会消耗更多 API 配额,建议在需要多角度核验时按需使用。
advanced_search 与 multi_search 的输出多了一个可选字段 meta.uncertainty,用来告诉 agent「这次结果有多可信」,不影响原有 provider / content / sources:
{ "provider": "multi", "sources": [ ... ],
  "meta": { "uncertainty": { "level": "medium", "notes": ["只有 2 个来源"] } } }
level:high / medium / low,按来源数量、站点是否同一家、带时间过滤却无发布时间、是否包含聚合站、是否有引擎失败等启发式判定;notes:具体原因(中文);high 时通常为空;- 渲染文本在非
high 时会追加一行 Confidence: …。
这是小步版:只新增字段,旧解析不受影响。
抓取网页内容(web_fetch)
搜索到 URL 后,可以让 agent 读取网页全文(如"打开第一个链接看看内容")。web_fetch 工具已启用(官方 dsh-web-fetch-http provider):
- 自动跟随重定向、解码正文(HTML 转文本)
- 支持超时和大小限制
- ⚠️ 注意:
web_fetch 默认拒绝回环、私网、链路本地和云元数据地址。若使用 Clash / mihomo TUN 的 fake-ip DNS,请把对应网段(常见 198.18.0.0/15)加入设置页的「额外允许的网段」,否则所有被代理域名都会被判成私网而抓取失败;只放行 fake-ip 网段,不要放行 RFC1918;IPv6 fake-ip 常用 ULA(如 fdfe:dcba:9876::/64),需要显式加入才会放行。
MCP server(stdio)
同仓库带一个独立的 stdio MCP server,供 Claude Desktop、Cursor、Codex 等 MCP 客户端使用,不依赖 DSH 运行时:
npx -y -p dsh-free-search dsh-free-search-mcp
第一版只暴露 web_search(Bing / DuckDuckGo,免 key)和 web_fetch(直连 / 浏览器 / Exa / Firecrawl);不暴露付费引擎、research、multi_search,也不监听端口。Claude Desktop 配置示例:
{
  "mcpServers": {
    "dsh-free-search": {
      "command": "npx",
      "args": ["-y", "-p", "dsh-free-search", "dsh-free-search-mcp"],
      "env": { "MCP_LANG": "zh", "MCP_SEARCH_ENGINE": "auto" }
    }
  }
}
环境变量:MCP_SEARCH_ENGINE(auto / bing / ddg / ddg-lite)、MCP_MAX_RESULTS、MCP_SAFE_SEARCH、MCP_LANG、MCP_BING_MARKET、MCP_BROWSER_FETCH、MCP_ALLOW_FAKE_IP_CIDRS;抓取层可用 EXA_API_KEY / FIRECRAWL_API_KEY。
让 agent 搜特定平台,如"在 GitHub 上搜 deepseek harness"、“看看 B站有什么相关视频”、“V2EX 上关于 dsh 的讨论”。platform_search 工具支持:
| 平台 |
用途 |
github |
GitHub 仓库搜索(API,免费无 key) |
v2ex |
V2EX 热门/相关主题 |
bilibili |
B站视频/内容搜索(公开接口) |
reddit |
Reddit 帖子/讨论搜索(公开 JSON API;部分网络环境可能被 Reddit 反爬拦截) |
hn |
Hacker News 技术社区讨论(Algolia 官方 API) |
stackoverflow |
Stack Overflow 技术问答(Stack Exchange 官方公开 API) |
wikipedia |
维基百科词条(子域跟随 lang:zh → zh.wikipedia.org、ja → ja.wikipedia.org;不支持的语言回落 en.wikipedia.org) |
npm |
npm 包搜索(registry 官方 API) |
youtube |
YouTube 视频搜索(抓 results 页 ytInitialData,免 key) |
vimeo |
Vimeo 视频搜索(抓搜索页内嵌数据;抓不到时退回网页搜索 site:vimeo.com,免 key) |
公开 API 或免 key 抓取,零外部依赖、无需任何 key。youtube / vimeo 需要先在设置页「平台搜索」里勾选启用。
视频搜索(video_search)
让 agent 找视频:“找几个关于 X 的视频”、“有没有 Y 的教学视频”。video_search 跨站搜索:
| 源 |
说明 |
bing |
Bing Videos(抓 bing.com/videos/search 的 vrhm 元数据,免 key) |
ddg |
DuckDuckGo Videos(vqd + v.js,免 key) |
默认两个源都试、失败互相回退,返回 url / title / snippet(来源站点、时长等)。免 key 抓取,对方改版可能失效;要按站点搜(YouTube / Vimeo / B站)请用 platform_search。
一次调用完成研究(research)
research 让 agent 一次调用拿到带出处的证据包:多引擎并发搜索 → 候选重排 → 分层抓取正文 → 段落选窗 → Markdown 简报。适合"需要多源核验的问题",可替代 agent 自己串联 web_search + web_fetch。
- 参数:
question(问题原文)、depth(抓取正文的篇数,1–5,默认 3;自动取整并夹到该区间)。
- 输出:
sources 检索结果、documents 抓到的正文(每条含 kind、text_origin、tier、published、fetched_at、engine_hits 等字段)、notes 执行注记、estimatedTokens 粗估 token。
- 共享预算:全阶段共用 90 秒截止(
DEADLINE_MS)与 12 次搜索调用上限(SEARCH_REQUESTS_MAX);到点取消在途请求、排队任务不再启动,并返回已拿到的部分结果,在 notes 里记 deadline_hit 或 budget_exhausted。
- 降级:重排、嵌入、决策模型任一失败即静默回退规则路径,不影响返回结果;抓取失败时退化为只用检索摘要(
snippets only)。
- 不可信边界:返回的简报包在
<untrusted-web-content> 内。
无 key 时的降级行为(基本路径仍可用,不会因缺 key 中断):
| 未配置的 key |
影响 |
SILICONFLOW_RERANK_API_KEY |
跳过候选重排与段落模型打分,改用轻筛排序;抓取前语义簇标记也跳过。notes 记录降级路径 |
DECISION_MODEL_API_KEY / DECISION_MODEL_URL |
决策模型整体关闭(decide() 直接返回 null),意图判定、充分性闸门、改写挑选全部走规则版。两者需同时配置才生效 |
EXA_API_KEY / FIRECRAWL_API_KEY / CRAWL4AI_API_KEY |
分层抓取自动跳过对应层,其余层照常 |
决策模型端点默认关闭(DECISION_MODEL_URL 默认为空串):不配置就不会外呼第三方端点。需要时自行指定 DECISION_MODEL_URL。
检索正文缓存(cache_search)
cache_search 全文检索 research 抓过的正文,用来"回头看之前查到什么",不必重新抓取。
- 参数:
query(检索词)、limit(返回条数上限,默认 8,最大 20)。
- 返回:
url / title / excerpt / fetched_at,同样包在 <untrusted-web-content> 内。
- 存储位置与清理:默认写入
~/.cache/dsh-free-search/research.db,可用环境变量 RESEARCH_CACHE_DIR 换成别的目录(指向备份盘、或想随项目走时用)。清理方式:删除该目录即可,没有后台任务残留、没有注册表项。缓存 7 天后过期,查询时惰性清理,过期行不占检索结果。
node:sqlite 不可用时降级:无法加载 node:sqlite 时缓存整体禁用(no-op)——research 正常运行,cache_search 返回空数组,插件不会因此报错。node:sqlite 自 v22.13.0 / v23.4.0 起免 flag;22.5–22.12 需以 --experimental-sqlite 启动,否则同样走 no-op。
tools/ 目录附带了一个本地切换小工具(零依赖):
启动搜索引擎切换器.cmd(Windows)——双击启动本地 Node 服务(http://127.0.0.1:4789)并自动打开浏览器选择页面switch-engine.html —— 选择页面:显示当前引擎,点选新引擎,一键写入配置server.mjs —— 本地服务,负责读写 ~/.dsh/profiles/web/cordis.patch.ymlswitch-engine.ps1 —— 无界面命令行版:powershell -File tools/switch-engine.ps1 -Engine bing
切换后重启 dsh web 生效。
仓库自带 61 个零依赖断言脚本(合计 882 项),不需要 API key、不联网、不需要测试框架,Node ≥ 20 即可跑。一次跑全部:npm test。
| 脚本 |
覆盖 |
运行(项数) |
assert-auto-default.mjs |
自动默认引擎:provider 留空时的地区判定(CN → bing、其它 → parallel)、探测失败回落 bing、DSH_FREE_SEARCH_DEFAULT 覆盖、提示词跟随、effectiveProvider 下发 |
node tools/assert-auto-default.mjs(7) |
assert-serp-engines.mjs |
HTML 搜索页家族:注册表不变式、时间过滤声明、默认不进 auto 与回退链、显式入池才生效、四个解析器的内联 fixture、反爬识别与文本清洗 |
node tools/assert-serp-engines.mjs(32) |
assert-engines.mjs |
引擎清单 / 免费引擎口径 / 语言分池路由 / 池配置字段 / 知乎 URL 剥 utm / deepseek-tools 接线与 snippetCap 放宽 |
node tools/assert-engines.mjs(41) |
assert-blocked-domains.mjs |
域名黑名单:解析、匹配、收口,且前后端清洗同口径 |
node tools/assert-blocked-domains.mjs(69) |
assert-multi-policy.mjs |
multi 执行策略:并发上限是天花板 / 目标成功源非硬下限 / 凭据资格在上限之前分流 / Fast·Balanced·Deep 档位 |
node tools/assert-multi-policy.mjs(146) |
assert-multi-limit.mjs |
multi 结果上限(#109):默认 20 / 硬上限 100 / 配置归一化、单次 maxResults 受上限约束、工具参数与本段提示词写明生效上限、设置页字段与保存 |
node tools/assert-multi-limit.mjs(6) |
assert-maintenance.mjs |
维护面:CI 在 Node 20/22/24 跑全部断言并过打包闸门、发布脚本会 bump / 校验 / 打 tag / 可发布、恢复官方 provider 的桥接与设置页按钮 |
node tools/assert-maintenance.mjs(4) |
assert-engine-modules.mjs |
引擎分层:实现文件存在且被 index 引用、引擎函数已迁出 index、设置页引擎 id 与服务端清单一致、清单覆盖 39 个引擎且免费/按次标记正确、index 不引用引擎私有名 |
node tools/assert-engine-modules.mjs(6) |
assert-bing-relevance.mjs |
Bing 相关性(#112):单字中文 token 被剔除、无关替代 SERP 被拒、真正相关的结果通过、只命中通用引擎名的整批被拒、单一 token 覆盖一半时放行、单字/纯数字查询的显式行为 |
node tools/assert-bing-relevance.mjs(6) |
assert-quality.mjs |
研究证据闸门:8 源 / 3 域 / 3 正文 / 2 日期为 high,3 源 / 2 域 / 1 正文为 medium,单源与失败注记为 low,空包为 low,research 的 schema/输出/brief 接线 |
node tools/assert-quality.mjs(6) |
assert-dedupe.mjs |
近重复去重:MinHash 同文本同签名、同 URL 去重、跨站转载去重、不同文章保留且顺序不变、阈值可调、provider 与 multi 两条路径接线 |
node tools/assert-dedupe.mjs(6) |
assert-intent-routing.mjs |
意图路由:五类领域与 general 分类、偏好重排稳定、Auto 头部按领域、自定义回退顺序不被重排、时间过滤仍生效、接线 |
node tools/assert-intent-routing.mjs(6) |
assert-result-ranking.mjs |
合并排序:eTLD+1 同域判定 / 域名轮转 / seenIn 降为末位 / 时效仅带时间过滤时生效 |
node tools/assert-result-ranking.mjs(31) |
assert-url-norm.mjs |
URL 规范化:只剔已审计的 tracking 参数,保留可能区分资源的参数 |
node tools/assert-url-norm.mjs(72) |
assert-prompt-contract.mjs |
系统提示词契约:检索≠抓取、不可信边界、模型内置搜索只在显式选中时运行 |
node tools/assert-prompt-contract.mjs(9) |
assert-research-degradation.mjs |
research 无 key 全降级、node:sqlite no-op、90s 预算隔离、缓存目录可配置、budget.exhausted 契约名 |
node tools/assert-research-degradation.mjs(19) |
assert-research-call-wrappers.mjs |
research 四个 call* 包装层的替身/底层透传(#75 回归) |
node tools/assert-research-call-wrappers.mjs(23) |
assert-fetch-chain.mjs |
fs-quality-fetch 四层链序、任一层命中即停、exa 失败静默降级 firecrawl、全层失败聚合报错 |
node tools/assert-fetch-chain.mjs(8) |
assert-fetch-ssrf.mjs |
抓取 SSRF 防护:公网/私网/保留地址判定、DNS 解析到私网拒绝、localhost 与 IP 字面量拒绝、非 HTTPS 与带凭据 URL 拒绝、fake-ip 网段默认拒绝且仅按配置放行、IPv6 ULA 显式放行、放行后仍拒绝回环/IPv4 私网/链路本地、provider 接线与设置项 |
node tools/assert-fetch-ssrf.mjs(8) |
assert-mcp.mjs |
MCP stdio 面:initialize 协议协商、tools/list 的 JSON Schema、tools/call 文本结果、工具错误与 JSON-RPC 错误区分、必填参数校验、bin/files 打包 |
node tools/assert-mcp.mjs(6) |
assert-mcp.mjs |
MCP stdio surface: initialize negotiation, tools/list JSON Schema, tools/call text results, tool errors vs JSON-RPC errors, required arguments, bin/files packaging |
node tools/assert-mcp.mjs (6) |
assert-baidu.mjs |
百度千帆:key 必填、web_search 首请求、403 或 results.code 额度错误回退 chat/completions(stream:false)、401 不回退、双端失败合并报错 |
node tools/assert-baidu.mjs(6) |
assert-deepseek-endpoint.mjs |
DeepSeek 搜索端点:默认地址、base/完整 URL 归一、自定义 endpoint 收 Bearer/key/query、配置与设置页接线 |
node tools/assert-deepseek-endpoint.mjs(4) |
assert-yuanbao.mjs |
key 必填、Bearer 网关/Query/Mode/Site/FromTime、自然与 VR 页面解析、日期归一、错误分类、注册与显式专用 |
node tools/assert-yuanbao.mjs(6) |
assert-yandex.mjs |
Yandex Search:key+folder 必填、Api-Key/请求体/分组、searchType 与 period/family 映射、Base64 XML 解析与日期、错误分类、注册与显式专用 |
node tools/assert-yandex.mjs(6) |
assert-metaso.mjs |
秘塔搜索:key 必填、请求体(q/scope/size/summary/raw/concise)、摘要与日期映射、文库数组、size 上限、无效 scope 回退、401/402/429/400 错误分类、注册与默认回退排除 |
node tools/assert-metaso.mjs(6) |
assert-google-cse.mjs |
Google Custom Search:key+ID 必填、请求参数(q/num/start/hl/safe/dateRestrict)、结果映射与发布日期、超过 10 条分页、403/429/400 错误分类、时间档映射、全链路注册 |
node tools/assert-google-cse.mjs(6) |
assert-engine-runtime.mjs |
引擎运行时:按引擎并</https:></https:></https:></https:></https:></https:></https:></https:></https:></https:></https:></https:></https:> |
|
README 内容过长,已截取前 64 KB。完整内容请前往 GitHub 仓库查看。


评论